障害情報の分析を自律化してみた(環境詳細)
目次
元記事
zenn に投稿した元記事はこちらです。
障害情報の調査と通知を自律化してみた zenn.dev

環境
実行環境の概要です。
| # | アプリ | 役割 | バージョン |
|---|---|---|---|
| 1 | job-api / slot-manager | 監視対象(自作)。FastAPI + OTel Python SDK | Python 3.13.15、fastapi 0.141.1、opentelemetry-sdk 1.44.0、instrumentation 0.65b0 |
| 2 | OpenTelemetry Collector | OTLP の振り分け | contrib 0.160.0 |
| 3 | Prometheus | メトリクス保存とアラート評価 | 3.14.0 |
| 4 | Loki | ログ保存、ruler でログ由来のアラート | 3.7.7 |
| 5 | Tempo | トレース保存、MCP サーバ(/api/mcp) | 3.0.0 |
| 6 | Alertmanager | webhook 転送 | 0.28.1 |
| 7 | Grafana | 可視化と annotation | 13.2.1 |
| 8 | mcp-grafana | MCP サーバ(読み取り専用。Tempo ツールも中継) | 1.4.1 |
| 9 | Claude Code | エージェント(Sonnet 5) | 2.1.268 |
| 10 | llama.cpp | ローカル LLM(Qwen3.6-35B-A3B UD-IQ3_XXS) | ghcr.io/ggml-org/llama.cpp:server-cuda、ctx 65536、--jinja |
| 11 | LiteLLM | Claude Code からローカル LLM への変換 | ghcr.io/berriai/litellm:main-stable |
| 12 | local_agent.py | ローカル LLM 用の最小エージェント(自作) | Python 3.14.0、mcp 2.21.0、openai SDK |
| 13 | Mattermost | 通知先(社内チャットの代わり) | mattermost-team-edition 11.11.0 + postgres:16-alpine |
| 14 | Docker Desktop(Windows) | 2〜8、11、13 のコンテナを動かす | Engine 29.7.2、Compose 5.5.0 |
| 15 | ハードウェア | GPU | RTX 5070 Ti 16 GB |
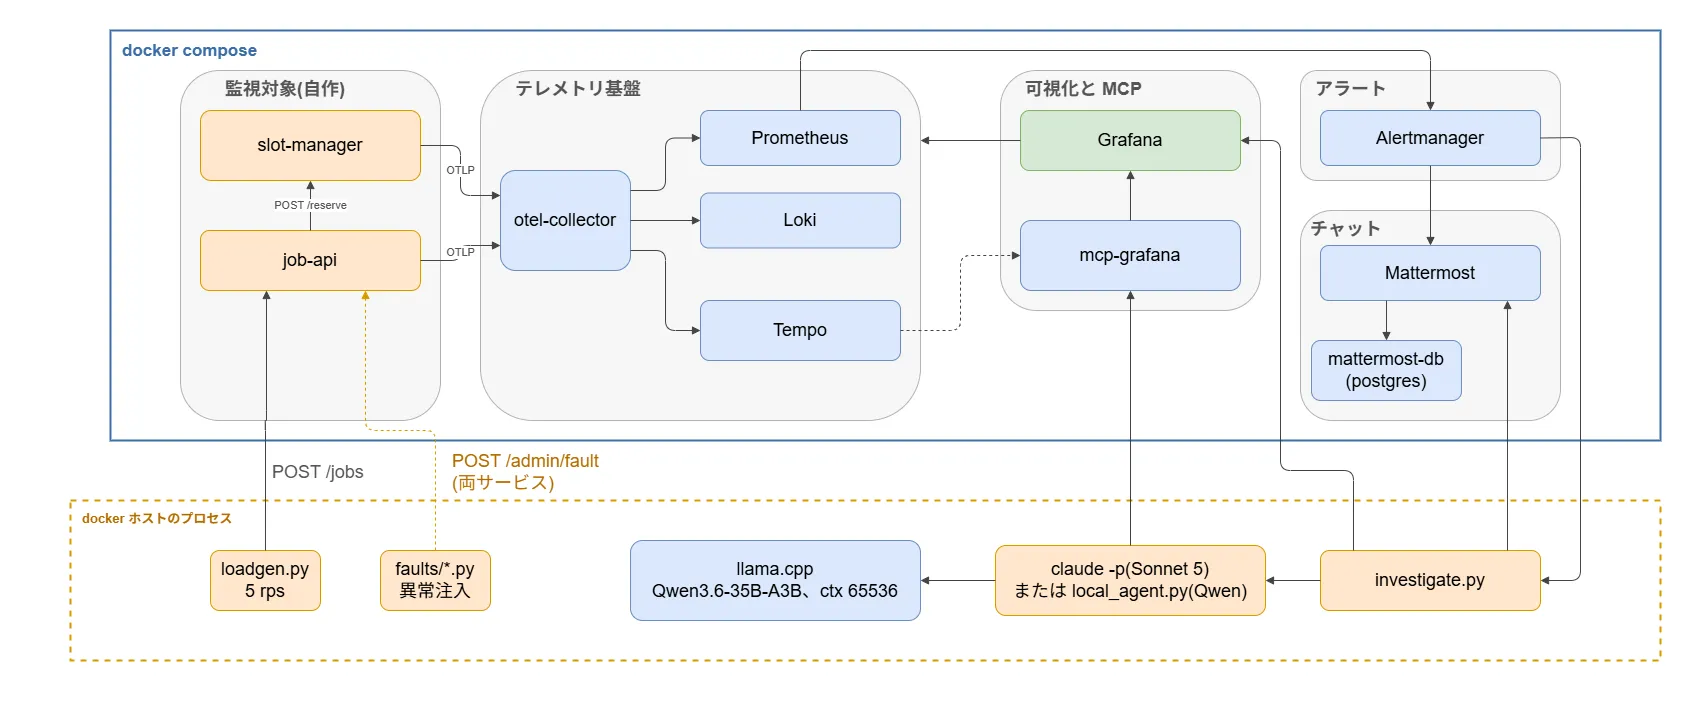 図1: docker compose の 12 コンテナと docker ホストのプロセス、ポート
監視対象(自作サービス)
監視対象のサービスとして、計算ジョブの投入システムを 2 サービスで作りました。
app/ に保存します。
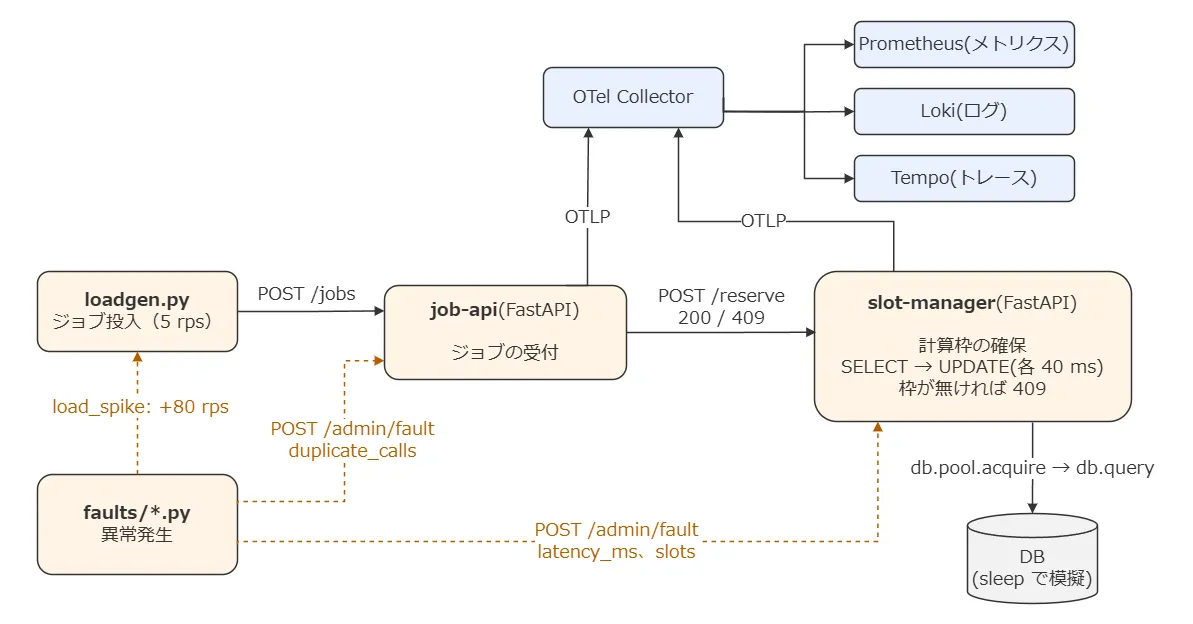 図2: 監視対象の 2 サービスと故障注入の入口
| サービス | ポート | エンドポイント | 役割 |
|---|---|---|---|
job-api | 8100 | POST /jobs、POST /admin/fault | ジョブ(種別 mip / lp / simulation / ml、size 1〜3)を受け、1 件ごとに slot-manager へ枠の確保を頼む |
slot-manager | 8101 | POST /reserve、POST /admin/fault | DB を SELECT → UPDATE(各 40 ms を sleep で模擬、接続プール 4 本)して枠を確保する。無ければ 409 |
計装は OTel Python SDKを利用します。
opentelemetry-instrumentation-fastapi と -httpx の自動計装に、標準 logging の LoggingHandler を足しました(app/telemetry.py)。
OTEL_SEMCONV_STABILITY_OPT_IN=http で http.server.request.duration(秒)が出力されます。
出力は次のとおりです。
| 出力情報 | 内容 |
|---|---|
| メトリクス | jobs_total{outcome = ok / failed}、jobs_duration_seconds(ヒストグラム)、自動計装の http_server_request_duration_seconds など。種別のラベルは付けない |
| ログ | job received / job submitted / job failed: ...(job-api)、reserved: mip x2 / failed to reserve: no free slot: mip / slots running low: mip(slot-manager)。属性 job.type、slots.remaining は Loki の構造化メタデータになる |
| トレース | POST /jobs → POST(httpx)→ POST /reserve → db.pool.acquire → db.query(db.operation.name = SELECT slots / UPDATE slots) |
異常の発生は POST /admin/fault で行います。
curl -s -X POST localhost:8101/admin/fault -d '{"latency_ms": 300}'      # DB を遅くする
curl -s -X POST localhost:8101/admin/fault -d '{"slots": {"mip": 0}}'     # mip の枠を 0 に
curl -s -X POST localhost:8100/admin/fault -d '{"duplicate_calls": 8}'   # 1 ジョブで 8 回 reserve する(二重投入のバグ)
curl -s -X POST localhost:8101/admin/fault -d '{"reset": true}'          # 戻す(8100 も同様)
Grafana 周辺環境
docker-compose.yml のサービスとポート。既存の Grafana などと衝突しないようずらしてある。
| サービス | イメージ | ホスト側ポート | 備考 |
|---|---|---|---|
| otel-collector | otel/opentelemetry-collector-contrib:0.160.0 | 4317、4318、8889 | OTLP 受信。トレース → Tempo、ログ → Loki(/otlp)、メトリクス → :8889 を Prometheus が scrape |
| prometheus | prom/prometheus:v3.14.0 | 9092 | alert_rules.yml を評価し Alertmanager へ |
| alertmanager | prom/alertmanager:v0.28.1 | 9094 | host.docker.internal:9095/alert へ webhook |
| loki | grafana/loki:3.7.7 | 3101 | ruler 有効。loki/rules/fake/job-system.yml を同じ Alertmanager へ |
| tempo | grafana/tempo:3.0.0 | 3200 | query_frontend.mcp_server.enabled: true |
| grafana | grafana/grafana:13.2.1 | 3082 | データソース 3 つと Job system ダッシュボードを provisioning |
| mcp-grafana | grafana/mcp-grafana:1.4.1 | 8097 | --disable-write と --disable-* で 27 ツールに絞る |
| litellm | ghcr.io/berriai/litellm:main-stable | 4000 | ローカル LLM 用 |
| mattermost | mattermost/mattermost-team-edition:11.11.0 | 8065 | 通知先。#alerts に Alertmanager の発火通知、#sonnet / #qwen にモデルごとの AI 調査レポート。DB は postgres:16-alpine(公開しない) |
アラートルール(Prometheus)。
| alert | 式 | for |
|---|---|---|
JobApiLatencyHigh | histogram_quantile(0.95, sum(rate(jobs_duration_seconds_bucket[2m])) by (le)) > 0.5 | 1m |
JobErrorRateHigh | sum(rate(jobs_total{outcome="failed"}[2m])) / sum(rate(jobs_total[2m])) > 0.2 | 1m |
ScrapeTargetDown | up == 0 | 1m |
Loki ruler のルール(ログ由来)。
- alert: SlotsRunningLow
  expr: sum(count_over_time({service_name="slot-manager"} |= "slots running low" [5m])) > 3
  for: 1m
mcp-grafana は --disable-write に加えて、調査に使わない分類(admin、dashboard、search、oncall、incident、sift、pyroscope、docs など 28 個)を --disable-* で落とした。
残るのは alerting / annotations / datasource / prometheus / loki / proxied(Tempo)の 27 ツール。
ツール定義のトークン量を減らすためで、Claude Code のシステムプロンプト約 18k に全 64 ツールを足すと 36k になり、ローカル LLM の 32k を初回で超えた。
Tempo は query_frontend.mcp_server.enabled: true で http://tempo:3200/api/mcp に MCP サーバを立てる。
mcp-grafana 1.4.1 はこれを tempo_traceql-search / tempo_get-trace / tempo_get-attribute-names など 7 つのツールとして中継する。
Claude Code の mcp.json は mcp-grafana 1 本でよい。
AI エージェント周辺環境
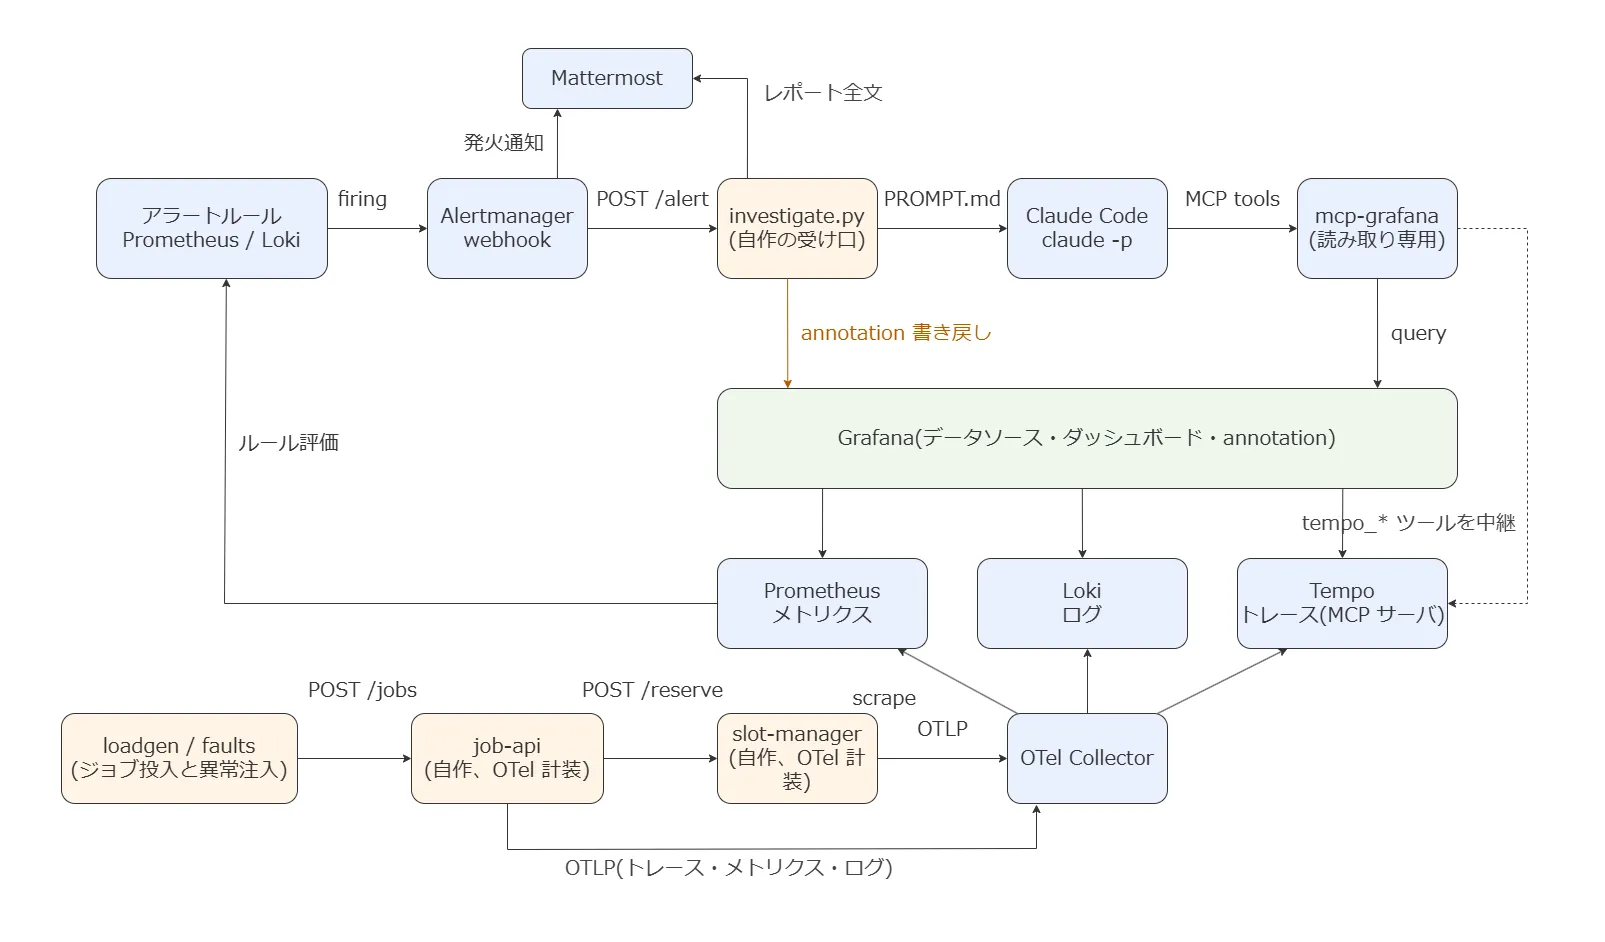 図3: 発火から調査、書き戻しまでの部品
sequenceDiagram
    participant P as Prometheus → Alertmanager
    participant R as investigate.py
    participant C as エージェント
    participant M as mcp-grafana / Grafana
    participant MM as Mattermost
    P->>MM: 発火通知(#35;alerts)
    P->>R: POST /alert(webhook)
    R->>R: 重複を除外(300 秒)
    R->>C: PROMPT.md で起動
    loop メトリクス → 仮説 → ログ・トレース
        C->>M: ツール呼び出し
        M-->>C: 結果
    end
    C-->>R: レポート
    R->>R: reports/ に保存
    R->>M: annotation(先頭 1,500 文字)
    R->>MM: レポート全文(#35;sonnet / #35;qwen)
図4: 発火から調査、通知までの流れ
受け口(investigate.py)
標準ライブラリだけの HTTP サーバ(ポート 9095)。
-
POST /alertで Alertmanager の webhook を受け、status == firingのアラートだけを対象にする -
同じ fingerprint は
DEDUP_SECONDS(実験中は 300)の間は再調査しない -
PROMPT.mdの{alert_json}をアラートの JSON で置き換え、claude -p --model sonnet --output-format json --mcp-config mcp.json --strict-mcp-config --allowedTools "mcp__grafana__*" --disallowedTools <組み込みツール全部> --no-session-persistenceを起動する -
結果を
reports/<UTC 時刻>_<alertname>.mdに保存し、所要時間・ターン数・トークン使用量をreports/results.jsonlに追記する -
レポートの先頭 1,500 文字を Grafana の annotation(
tags: ["ai-investigation", alertname])に書き戻す。認証は実験なので admin の基本認証 -
レポートの全文(Markdown)を Mattermost の
#alertsに incoming webhook で投稿する(上限 16,000 文字)。投稿先は環境変数MATTERMOST_CHANNELで変えられる。実験では Sonnet 5 の受け口を#sonnet、Qwen の受け口を#qwenに向けて、モデルごとにレポートを分けた
CLAUDE_BIN を差し替えると別のエージェントを同じ受け口で動かせる。
通知先(Mattermost)
プロキシ越しに Slack や Teams へ出られないオンプレを想定し、通知先は同じ compose に立てた Mattermost(Team Edition)にした。
Alertmanager の slack_configs は Mattermost の incoming webhook をそのまま受け付けるので、発火と解消は Alertmanager から、調査レポートは受け口から、同じ #alerts に届く。
docker compose up -d mattermost      # mattermost-db(PostgreSQL)も上がる
python setup_mattermost.py           # 管理者 / チーム ops / チャンネル alerts / webhook を作り、.env と alertmanager.yml を生成
docker compose restart alertmanager
alertmanager/alertmanager.yml は alertmanager.tmpl.yml の {{MATTERMOST_HOOK_ID}} を埋めて生成する。画面は http://localhost:8065(初期ユーザーは setup_mattermost.py の引数)。
受け口の投稿先は環境変数 MATTERMOST_CHANNEL(既定 alerts)で変えられる。incoming webhook は投稿時にチャンネル名を指定できるので、webhook は 1 本のままでよい。
実験ではモデルごとにチャンネルを分け、Sonnet 5 の受け口は #sonnet、Qwen の受け口は #qwen に投稿させた。
python setup_mattermost.py --channel sonnet # チャンネルだけ足す(webhook は既存を使い回す)
python setup_mattermost.py --channel qwen
MATTERMOST_CHANNEL=sonnet python investigate.py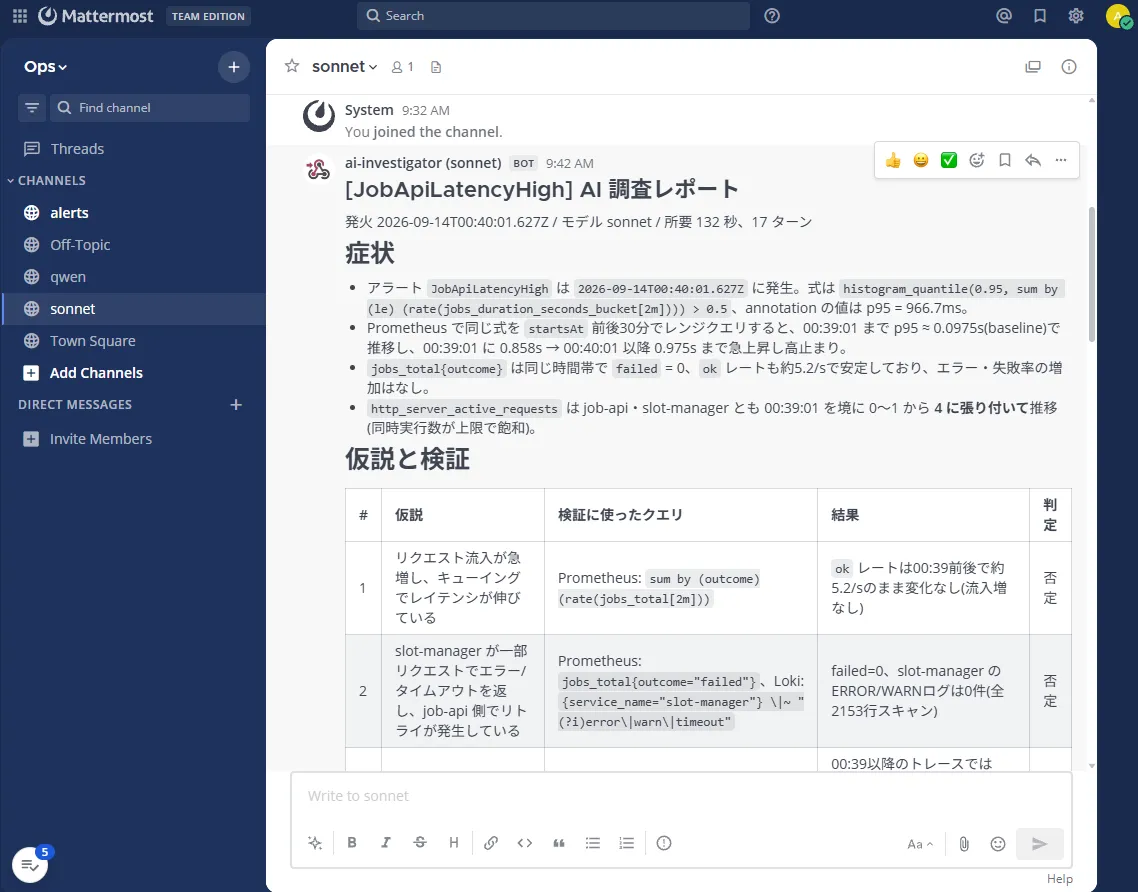 図5: #sonnet に届いた調査レポート
プロンプト(PROMPT.md)
アラートの JSON、監視対象 2 サービスとデータソース 3 つの説明、クエリの書き方(PromQL の窓と stepSeconds、LogQL のフィルタ、TraceQL の例)、手順(メトリクス → 仮説 → ログとトレース → annotation)、出力の見出し構成(症状 / 仮説と検証 / 結論 / 次の一手)。
v2 で「調べ方の原則」を 3 行足した。
- エラーの原因は、エラーを返した側(下流)のログから引く。呼び出し側の HTTP ステータスは結果であって原因ではない
- 失敗が一部に偏っていないか(種別・対象・ユーザー)をログの属性で集計し、偏りの値を結論に書く
- 過去の調査結果(annotation)は参考に留め、今回の時間帯のデータで確認できたことだけを根拠にする
ローカル LLM
llama.cpp は既存のスタック(ghcr.io/ggml-org/llama.cpp:server-cuda)を使う。関係する起動オプションは -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-IQ3_XXS、-c 65536(既定 32768 から上げた)、-fa on、--cache-type-k q8_0 --cache-type-v q8_0、-np 1、--jinja(tool calling に必要)、--reasoning。
16 GB の GPU で ctx 65536 にすると空き VRAM は約 1.6 GB。
Claude Code のモデルだけを差し替える経路は LiteLLM を使う。litellm/config.yaml で qwen3.6-35b-a3b を openai/qwen3.6-35b-a3b(api_base: http://host.docker.internal:8099/v1)に対応づけ、Claude Code 側は環境変数で向きを変える。
$env:ANTHROPIC_BASE_URL = "http://localhost:4000"
$env:ANTHROPIC_AUTH_TOKEN = "sk-local"
$env:ANTHROPIC_MODEL = "qwen3.6-35b-a3b"
$env:ANTHROPIC_SMALL_FAST_MODEL = "qwen3.6-35b-a3b"
$env:CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC = "1"
$env:CLAUDE_MODEL = "qwen3.6-35b-a3b"
この経路は 32k でも 64k でもコンテキストを超えたので、記事の計測では自作の local_agent.py を使った。
mcp SDK(Streamable HTTP)で mcp-grafana のツール一覧を取り、OpenAI 互換 API に function calling で回す約 200 行。
受け口の CLAUDE_BIN を python local_agent.py にすると差し替わる。既定値は次のとおり(環境変数で変えられる)。
| 項目 | 値 | 理由 |
|---|---|---|
| ツール呼び出しの予算 | 20 回(LOCAL_MAX_TOOL_CALLS) | 各結果の末尾に残り回数を付け、使い切ったら報告を書かせる |
| ツール結果の上限 | 6,000 文字(LOCAL_MAX_TOOL_CHARS) | Tempo の検索結果とトレースは表に整形してから収める |
| 圧縮を始める prompt_tokens | 52,000(LOCAL_COMPACT_AT) | 古いツール結果を 300 文字に畳む |
| サンプリング | 温度 0.6、top_p 0.95、presence_penalty 1.0 | Qwen3 の推奨値。温度 0.2 では同じ文の繰り返しに入った |
| 同じ引数の再呼び出し | 実行せず注意文を返す | |
| 本文に漏れた思考 | </think> より前を落とす | llama.cpp が分離し損ねたとき用 |
ツール呼び出しの回し方は次のとおり。
sequenceDiagram
    participant R as investigate.py
    participant L as local_agent.py
    participant M as mcp-grafana(MCP)
    participant Q as llama.cpp(Qwen3.6-35B-A3B)
    R->>L: プロンプト(標準入力)
    L->>M: tools/list(27 ツール)
    L->>Q: system + プロンプト + ツール定義
    loop 最大 20 回のツール呼び出し
        Q-->>L: tool_calls
        alt 同じ引数の再呼び出し
            L-->>Q: 実行せず注意文を返す
        else 新しい呼び出し
            L->>M: tools/call
            M-->>L: 結果
            L->>L: Tempo の結果は表に整形、6,000 文字で切る、残り回数を付ける
            L-->>Q: tool result
        end
        opt prompt_tokens が 52,000 を超えた
            L->>L: 古いツール結果を 300 文字に畳む
        end
    end
    Q-->>L: 最終レポート(思考タグより前を落とす)
    L-->>R: JSON(result、num_turns、duration_ms)
図6: local_agent.py の 1 回の調査
32k で使うなら 14 回 / 3,000 文字 / 24,000 に下げる。
docker compose 起動手順
docker compose up -d --build- Mattermost の初期設定:
python setup_mattermost.pyのあとdocker compose restart alertmanager(初回だけ) - 平常時の負荷を流す:
python loadgen.py --rps 5 - 受け口を起動する:
python investigate.py(GRAFANA_URLの既定はhttp://localhost:3082)。ローカル LLM ならCLAUDE_BIN="python local_agent.py" CLAUDE_MODEL=qwen3.6-35b-a3bを付ける。投稿先を分けるならMATTERMOST_CHANNEL=sonnetのように付ける docker compose psで 12 コンテナが Up、Grafana(3082)で Prometheus / Loki / Tempo の 3 データソースが緑、claude mcp listで grafana が connected、であれば準備完了
docker ホストが Windows で、別の PC から ssh で操作するときの注意が 2 つある。
- 公開鍵認証の ssh セッションでは Docker の資格情報ヘルパー(wincred)が「A specified logon session does not exist」で落ち、
docker pullとcompose buildが失敗する。PATH から Docker のディレクトリを外して docker.exe をフルパスで呼び、DOCKER_CONFIGを空のconfig.jsonに向けると匿名で pull できる - ssh セッションから
Start-Processした常駐プロセス(受け口、loadgen)はセッションが切れると死ぬ。Invoke-CimMethod -ClassName Win32_Process -MethodName Createで起動するとセッションから切り離される
実験手順
共通: 前の故障を戻し、アラートが解消してから 5 分空けて次を注入する。故障スクリプトは注入 → 指定秒数待つ → 戻す、まで行う。 ただしプロンプトの検索窓は発火の前後 30 分なので、5 分では前の実験のトレースが窓に残る。実験 3 の Qwen は 20 分前の実験 1 のトレースを開いて誤答した。前の実験の痕跡を完全に消すなら 30 分空ける。
sequenceDiagram
    participant E as 実験者(faults/*.py)
    participant S as job-api / slot-manager
    participant P as Prometheus → Alertmanager
    participant R as investigate.py → Mattermost
    E->>S: POST /admin/fault(reset)
    Note over S,P: 解消を待ち、さらに 5 分空ける
    E->>S: POST /admin/fault(注入。600 秒で自動復旧)
    S-->>P: メトリクスが変わる(投入は 5 rps のまま)
    P->>R: firing → webhook(注入の 1〜3 分後)
    R-->>R: 調査(Sonnet 5 約 2 分、Qwen 約 40 秒)
    Note over E,R: reports/ を読み、故障を名指しできたかを ○△× で採点
図7: 1 回の実験の手順
実験1(投入の急増)
python faults/load_spike.py --rps 80 --seconds 600 --max-inflight 60平常 5 rps に 80 rps を上乗せする。DB の接続プール 4 本 × 80 ms/ジョブ = 約 50 rps を超えるのでプール待ちが伸び、JobApiLatencyHigh が注入の約 1 分 20 秒後に発火する。
--max-inflight 60 で同時実行を頭打ちにする。頭打ちなしだと待ち行列が無限に伸び、job-api の httpx タイムアウトが 502 になって JobErrorRateHigh まで鳴る。
実験2(特定種別の枠切れ)
python faults/slot_out.py --job mip --seconds 600mip の枠を 0 にする。mip の投入(全体の約 25%)だけが 409 で失敗し、JobErrorRateHigh が約 2 分 40 秒後に発火する。
--slots 45 --seconds 25 にすると slots running low の警告だけが出て、Loki ruler の SlotsRunningLow が鳴る(2b)。
実験3(DB の遅延)
python faults/slow_db.py --latency-ms 300 --seconds 600slot-manager の DB 問い合わせに 300 ms を足す。1 ジョブで 2 回問い合わせるので投入 1 件が約 0.7 秒になり、実験 1 と同じ JobApiLatencyHigh が約 1 分 20 秒後に発火する。
python faults/retry_storm.py --calls 8 は job-api が 1 ジョブで 8 回 reserve するバグ(3b)。
判定
reports/<時刻>_<alertname>.md を読み、注入した故障を原因として名指しできたかを○△×で採点する。所要時間とターン数は reports/results.jsonl。
ローカル LLM の場合はツール呼び出しの記録(呼んだツール、引数、結果の文字数)が reports/<時刻>_<alertname>.log に残る。
Claude Code の場合は --output-format json の出力に最終レポートしか入らないので、どのクエリを実行したかはレポートの「検証に使ったクエリ」列から追う。呼び出しまで残すなら --output-format stream-json にして受け口で保存する。
レポートの主張は Loki や Tempo に同じクエリを直接投げて突き合わせる。実験 2 なら sum by (job_type) (count_over_time({service_name="slot-manager"} |= "failed to reserve" [10m])) で失敗が 1 種別に偏っているかを数える。
コード
実験に使ったコードと設定の全文。zenn 側のリポジトリは非公開なので、ここに置く。ファイル名をクリックすると開く。
スタック
docker-compose.yml 12 コンテナの定義。ポートは既存環境とずらしてある
# アラート起点の自律調査(レベル1〜3)の実験スタック。
# 監視対象は自作の計算ジョブ投入システム(job-api / slot-manager)。メトリクス・ログ・トレースを
# OTLP で Collector に送り、Prometheus / Loki / Tempo に振り分ける。
# 受け口(investigate.py)は claude CLI が必要なので docker ホストで動かす。
#   Grafana      : http://localhost:3082 (admin / admin)
#   Prometheus   : http://localhost:9092
#   Alertmanager : http://localhost:9094
#   mcp-grafana  : http://localhost:8097/mcp
#   Tempo MCP    : http://localhost:3200/api/mcp
#   Loki         : http://localhost:3101
#   job-api      : http://localhost:8100
#   slot-manager : http://localhost:8101
# 既存の Grafana / Prometheus / Loki と衝突しないようポートをずらしてある。
name: grafana-alert

x-app: &app
  build: ./app
  restart: unless-stopped
  environment:
    OTEL_EXPORTER_OTLP_ENDPOINT: http://otel-collector:4317
    OTEL_EXPORTER_OTLP_INSECURE: "true"
    OTEL_SEMCONV_STABILITY_OPT_IN: http
    PYTHONUNBUFFERED: "1"
  depends_on:
    - otel-collector

services:
  job-api:
    <<: *app
    command: uvicorn job_api:app --host 0.0.0.0 --port 8000 --no-access-log
    ports:
      - "8100:8000"
    environment:
      OTEL_EXPORTER_OTLP_ENDPOINT: http://otel-collector:4317
      OTEL_EXPORTER_OTLP_INSECURE: "true"
      OTEL_SEMCONV_STABILITY_OPT_IN: http
      PYTHONUNBUFFERED: "1"
      SLOT_MANAGER_URL: http://slot-manager:8000
    depends_on:
      - otel-collector
      - slot-manager

  slot-manager:
    <<: *app
    command: uvicorn slot_manager:app --host 0.0.0.0 --port 8000 --no-access-log
    ports:
      - "8101:8000"

  otel-collector:
    image: otel/opentelemetry-collector-contrib:0.160.0
    volumes:
      - ./otel-collector/config.yaml:/etc/otelcol-contrib/config.yaml:ro
    ports:
      - "4317:4317"
      - "4318:4318"
      - "8889:8889"
    depends_on:
      - loki
      - tempo
    restart: unless-stopped

  loki:
    image: grafana/loki:3.7.7
    ports:
      - "3101:3100"
    volumes:
      - ./loki/config.yaml:/etc/loki/config.yaml:ro
      - ./loki/rules:/loki/rules:ro
      - loki-data:/loki
    command:
      - -config.file=/etc/loki/config.yaml
    restart: unless-stopped

  tempo:
    image: grafana/tempo:3.0.0
    user: "0"
    ports:
      - "3200:3200"
    volumes:
      - ./tempo/config.yaml:/etc/tempo/config.yaml:ro
      - tempo-data:/var/tempo
    command:
      - -config.file=/etc/tempo/config.yaml
    restart: unless-stopped

  prometheus:
    image: prom/prometheus:v3.14.0
    ports:
      - "9092:9090"
    volumes:
      - ./prometheus/prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./prometheus/alert_rules.yml:/etc/prometheus/alert_rules.yml:ro
      - prometheus-data:/prometheus
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.retention.time=15d
    restart: unless-stopped

  alertmanager:
    image: prom/alertmanager:v0.28.1
    ports:
      - "9094:9093"
    volumes:
      - ./alertmanager/alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro
    command:
      - --config.file=/etc/alertmanager/alertmanager.yml
    extra_hosts:
      - "host.docker.internal:host-gateway"
    restart: unless-stopped

  grafana:
    image: grafana/grafana:13.2.1
    ports:
      - "3082:3000"
    environment:
      GF_SECURITY_ADMIN_USER: admin
      GF_SECURITY_ADMIN_PASSWORD: admin
      GF_USERS_ALLOW_SIGN_UP: "false"
      # スクリーンショット用にログインなしの閲覧を許可(自宅 PC 内に閉じている前提)
      GF_AUTH_ANONYMOUS_ENABLED: "true"
      GF_AUTH_ANONYMOUS_ORG_ROLE: Viewer
    volumes:
      - ./grafana/provisioning:/etc/grafana/provisioning:ro
      - ./grafana/dashboards:/var/lib/grafana/dashboards:ro
      - grafana-data:/var/lib/grafana
    depends_on:
      - prometheus
      - loki
      - tempo
    restart: unless-stopped

  mcp-grafana:
    image: grafana/mcp-grafana:1.4.1
    ports:
      - "8097:8000"
    environment:
      GRAFANA_URL: http://grafana:3000
      # 実験なので admin の基本認証。本番はサービスアカウントのトークンにする
      GRAFANA_USERNAME: admin
      GRAFANA_PASSWORD: admin
    command:
      - -t
      - streamable-http
      - --address
      - 0.0.0.0:8000
      # エージェントは読み取り専用。annotation の書き戻しは受け口が REST API で行う
      - --disable-write
      # 調査に使わないツール群を落として、ツール定義のトークン量を減らす(64 個 → 20 個弱)。
      # 残すのは alerting / annotations / datasource / prometheus / loki / proxied(Tempo の MCP)
      - --disable-admin
      - --disable-agento11y
      - --disable-api
      - --disable-asserts
      - --disable-assistant
      - --disable-cloudwatch
      - --disable-config
      - --disable-dashboard
      - --disable-docs
      - --disable-elasticsearch
      - --disable-examples
      - --disable-folder
      - --disable-graphite
      - --disable-incident
      - --disable-influxdb
      - --disable-navigation
      - --disable-oncall
      - --disable-plugin
      - --disable-provisioning
      - --disable-pyroscope
      - --disable-quickwit
      - --disable-rendering
      - --disable-runpanelquery
      - --disable-search
      - --disable-sift
      - --disable-snapshot
      - --disable-snowflake
      - --disable-sql
      - --disable-user
      - --allowed-hosts
      - ${MCP_ALLOWED_HOSTS:-*}
      - --allowed-origins
      - ${MCP_ALLOWED_ORIGINS:-*}
    depends_on:
      - grafana
    restart: unless-stopped

  # ローカル LLM 用。Claude Code の Anthropic 形式を llama.cpp(OpenAI 互換)へ変換する
  litellm:
    image: ghcr.io/berriai/litellm:main-stable
    ports:
      - "4000:4000"
    volumes:
      - ./litellm/config.yaml:/app/config.yaml:ro
    command:
      - --config
      - /app/config.yaml
      - --port
      - "4000"
    extra_hosts:
      - "host.docker.internal:host-gateway"
    restart: unless-stopped

  # 社内チャットの代わり。Alertmanager の発火通知と受け口の調査レポートを #alerts に投稿する
  mattermost-db:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: mmuser
      POSTGRES_PASSWORD: mmpass
      POSTGRES_DB: mattermost
    volumes:
      - mattermost-db:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U mmuser -d mattermost"]
      interval: 5s
      timeout: 3s
      retries: 20
    restart: unless-stopped

  mattermost:
    image: mattermost/mattermost-team-edition:11.11.0
    ports:
      - "8065:8065"
    environment:
      MM_SQLSETTINGS_DRIVERNAME: postgres
      MM_SQLSETTINGS_DATASOURCE: postgres://mmuser:mmpass@mattermost-db:5432/mattermost?sslmode=disable&connect_timeout=10
      MM_SERVICESETTINGS_SITEURL: ${MM_SITEURL:-http://localhost:8065}
      MM_SERVICESETTINGS_ENABLEINCOMINGWEBHOOKS: "true"
      MM_SERVICESETTINGS_ENABLEPOSTUSERNAMEOVERRIDE: "true"
      MM_SERVICESETTINGS_ENABLEPOSTICONOVERRIDE: "true"
      MM_EMAILSETTINGS_REQUIREEMAILVERIFICATION: "false"
      MM_PLUGINSETTINGS_ENABLEMARKETPLACE: "false"
      MM_LOGSETTINGS_CONSOLELEVEL: ERROR
    volumes:
      - mattermost-config:/mattermost/config
      - mattermost-data:/mattermost/data
      - mattermost-logs:/mattermost/logs
      - mattermost-plugins:/mattermost/plugins
      - mattermost-client-plugins:/mattermost/client/plugins
    depends_on:
      mattermost-db:
        condition: service_healthy
    restart: unless-stopped

volumes:
  mattermost-db:
  mattermost-config:
  mattermost-data:
  mattermost-logs:
  mattermost-plugins:
  mattermost-client-plugins:
  prometheus-data:
  grafana-data:
  loki-data:
  tempo-data:
otel-collector/config.yaml OTLP を Tempo / Loki / Prometheus に振り分ける
# アプリからの OTLP を受けて 3 つの保存先に振り分ける。
#   トレース   -> Tempo(OTLP gRPC)
#   ログ       -> Loki(OTLP HTTP。service.name などがインデックスのラベルになる)
#   メトリクス -> :8889 で Prometheus 形式で公開し、Prometheus がスクレイプする
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  batch:
    timeout: 2s

exporters:
  otlp/tempo:
    endpoint: tempo:4317
    tls:
      insecure: true
  otlphttp/loki:
    endpoint: http://loki:3100/otlp
  prometheus:
    endpoint: 0.0.0.0:8889
    # service.name などのリソース属性を service_name のようなラベルにも展開する
    resource_to_telemetry_conversion:
      enabled: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlp/tempo]
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [prometheus]
    logs:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/loki]
prometheus/prometheus.yml Collector の :8889 をスクレイプ。honor_labels で service_name を残す
global:
  scrape_interval: 15s
  evaluation_interval: 15s

rule_files:
  - /etc/prometheus/alert_rules.yml

alerting:
  alertmanagers:
    - static_configs:
        - targets: ["alertmanager:9093"]

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]

  # アプリのメトリクスは OTLP で Collector に届き、Collector が Prometheus 形式で公開する。
  # honor_labels: Collector が付ける job / instance(= service.name / service.instance.id)を優先する
  - job_name: otel-collector
    honor_labels: true
    static_configs:
      - targets: ["otel-collector:8889"]
prometheus/alert_rules.yml 実験 1〜3 のアラートルール
# 実験 1〜3 に対応するアラートルール。
# しきい値は人が書く。ラベルに原因のヒント(scenario など)を入れない。
# 実験 1(負荷)と実験 3(下流の DB の遅延)は同じ JobApiLatencyHigh を鳴らし、原因だけが違う。
groups:
  - name: job-system
    rules:
      - alert: JobApiLatencyHigh
        expr: histogram_quantile(0.95, sum(rate(jobs_duration_seconds_bucket[2m])) by (le)) > 0.5
        for: 1m
        labels:
          severity: warning
        annotations:
          summary: "ジョブ投入 API の p95 レイテンシが 1 分以上 0.5 秒を超えている"
          description: "直近 2 分の p95 = {{ $value | humanizeDuration }}"

      - alert: JobErrorRateHigh
        expr: sum(rate(jobs_total{outcome="failed"}[2m])) / sum(rate(jobs_total[2m])) > 0.2
        for: 1m
        labels:
          severity: warning
        annotations:
          summary: "ジョブ投入の失敗率が 1 分以上 20% を超えている"
          description: "直近 2 分の失敗率 = {{ $value | humanizePercentage }}"

      - alert: ScrapeTargetDown
        expr: up == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "スクレイプ対象 {{ $labels.job }} が応答しない"
          description: "{{ $labels.instance }} の up が 1 分以上 0"
alertmanager/alertmanager.tmpl.yml 受け口への webhook と Mattermost への通知(setup_mattermost.py が alertmanager.yml を生成)
# alertmanager.yml のひな型。setup_mattermost.py が {{MATTERMOST_HOOK_ID}} を埋めて alertmanager.yml を書く。
# 発火したアラートは 2 か所へ送る:
#   1. docker ホストの受け口(investigate.py、ポート 9095)。AI 調査を起動する
#   2. Mattermost の #alerts(Slack 互換の incoming webhook)。運用者への通知
route:
  receiver: ai-investigator
  group_by: ["alertname"]
  group_wait: 10s
  group_interval: 1m
  repeat_interval: 4h

receivers:
  - name: ai-investigator
    webhook_configs:
      - url: http://host.docker.internal:9095/alert
        send_resolved: false
    slack_configs:
      - api_url: http://mattermost:8065/hooks/{{MATTERMOST_HOOK_ID}}
        channel: "#alerts"
        username: alertmanager
        send_resolved: true
        title: "{{ .CommonLabels.alertname }} [{{ .Status | toUpper }}]"
        text: '{{ range .Alerts }}{{ .Annotations.summary }}{{ if .Annotations.description }}: {{ .Annotations.description }}{{ end }}{{ "\n" }}{{ end }}'
        color: '{{ if eq .Status "firing" }}danger{{ else }}good{{ end }}'
loki/config.yaml 単一ノードの Loki。ruler を Alertmanager に向ける
# 単一ノードの Loki。OTLP で受けたログをローカルディスクに保存する。
# ruler を有効にして、ログ由来のアラート(rules/fake/*.yml)を Alertmanager に送る。
auth_enabled: false

server:
  http_listen_port: 3100
  grpc_listen_port: 9096

common:
  path_prefix: /loki
  storage:
    filesystem:
      chunks_directory: /loki/chunks
      rules_directory: /loki/rules
  replication_factor: 1
  ring:
    kvstore:
      store: inmemory

schema_config:
  configs:
    - from: "2024-04-01"
      store: tsdb
      object_store: filesystem
      schema: v13
      index:
        prefix: index_
        period: 24h

limits_config:
  allow_structured_metadata: true
  volume_enabled: true

ruler:
  storage:
    type: local
    local:
      directory: /loki/rules
  rule_path: /tmp/loki-rules
  alertmanager_url: http://alertmanager:9093
  ring:
    kvstore:
      store: inmemory
  enable_api: true
loki/rules/fake/job-system.yml ログ由来のアラート(実験 2b)
# ログ由来のアラート(実験 2b)。メトリクスには何も出ず、ログの行数だけで鳴る。
# "fake" は auth_enabled: false のときのテナント名。
groups:
  - name: job-system
    rules:
      - alert: SlotsRunningLow
        expr: sum(count_over_time({service_name="slot-manager"} |= "slots running low" [5m])) > 3
        for: 1m
        labels:
          severity: warning
        annotations:
          summary: "計算枠が少ないという警告ログが 5 分で 3 行を超えた"
tempo/config.yaml MCP サーバを有効にした Tempo
# 単一ノードの Tempo。OTLP で受けたトレースをローカルディスクに保存する。
# query_frontend.mcp_server を有効にすると http://tempo:3200/api/mcp に
# MCP サーバ(traceql-search / get-trace など)が立つ。mcp-grafana には Tempo ツールが無いので併用する。
server:
  http_listen_port: 3200

distributor:
  receivers:
    otlp:
      protocols:
        grpc:
          endpoint: 0.0.0.0:4317
        http:
          endpoint: 0.0.0.0:4318

storage:
  trace:
    backend: local
    local:
      path: /var/tempo/blocks
    wal:
      path: /var/tempo/wal

query_frontend:
  mcp_server:
    enabled: true
grafana/provisioning/datasources/datasources.yml Prometheus / Loki / Tempo のデータソース
apiVersion: 1
datasources:
  - name: Prometheus
    type: prometheus
    uid: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true

  - name: Loki
    type: loki
    uid: loki
    access: proxy
    url: http://loki:3100

  - name: Tempo
    type: tempo
    uid: tempo
    access: proxy
    url: http://tempo:3200
    jsonData:
      tracesToLogsV2:
        datasourceUid: loki
        spanStartTimeShift: "-5m"
        spanEndTimeShift: "5m"
        filterByTraceID: true
      serviceMap:
        datasourceUid: prometheus
grafana/provisioning/dashboards/dashboards.yml ダッシュボードの自動登録
apiVersion: 1
providers:
  - name: grafana-alert
    folder: ""
    type: file
    options:
      path: /var/lib/grafana/dashboards
grafana/dashboards/job-system.json ダッシュボード(p95、投入レート、失敗率、ログ、up。annotation を重ねる)
{
  "uid": "job-system",
  "title": "Job system",
  "tags": ["grafana-alert"],
  "timezone": "browser",
  "schemaVersion": 39,
  "refresh": "10s",
  "time": { "from": "now-30m", "to": "now" },
  "annotations": {
    "list": [
      {
        "name": "AI investigation",
        "datasource": { "type": "grafana", "uid": "-- Grafana --" },
        "enable": true,
        "iconColor": "orange",
        "target": {
          "type": "tags",
          "tags": ["ai-investigation"],
          "limit": 100,
          "matchAny": true
        }
      }
    ]
  },
  "panels": [
    {
      "id": 1,
      "type": "timeseries",
      "title": "ジョブ投入 p95 レイテンシ(アラート式)",
      "gridPos": { "x": 0, "y": 0, "w": 12, "h": 8 },
      "datasource": { "type": "prometheus", "uid": "prometheus" },
      "fieldConfig": {
        "defaults": {
          "unit": "s",
          "thresholds": {
            "mode": "absolute",
            "steps": [
              { "color": "green", "value": null },
              { "color": "red", "value": 0.5 }
            ]
          },
          "custom": { "thresholdsStyle": { "mode": "line" } }
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "histogram_quantile(0.95, sum(rate(jobs_duration_seconds_bucket[2m])) by (le))",
          "legendFormat": "p95"
        }
      ]
    },
    {
      "id": 2,
      "type": "timeseries",
      "title": "ジョブ投入レート(結末別)",
      "gridPos": { "x": 12, "y": 0, "w": 12, "h": 8 },
      "datasource": { "type": "prometheus", "uid": "prometheus" },
      "fieldConfig": { "defaults": { "unit": "reqps" }, "overrides": [] },
      "targets": [
        {
          "refId": "A",
          "expr": "sum(rate(jobs_total[1m])) by (outcome)",
          "legendFormat": "{{outcome}}"
        }
      ]
    },
    {
      "id": 3,
      "type": "timeseries",
      "title": "ジョブ投入の失敗率(アラート式)",
      "gridPos": { "x": 0, "y": 8, "w": 12, "h": 8 },
      "datasource": { "type": "prometheus", "uid": "prometheus" },
      "fieldConfig": {
        "defaults": {
          "unit": "percentunit",
          "min": 0,
          "max": 1,
          "thresholds": {
            "mode": "absolute",
            "steps": [
              { "color": "green", "value": null },
              { "color": "red", "value": 0.2 }
            ]
          },
          "custom": { "thresholdsStyle": { "mode": "line" } }
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "sum(rate(jobs_total{outcome=\"failed\"}[2m])) / sum(rate(jobs_total[2m]))",
          "legendFormat": "failed"
        }
      ]
    },
    {
      "id": 4,
      "type": "timeseries",
      "title": "サービス別 HTTP p95(自動計装)",
      "gridPos": { "x": 12, "y": 8, "w": 12, "h": 8 },
      "datasource": { "type": "prometheus", "uid": "prometheus" },
      "fieldConfig": { "defaults": { "unit": "s" }, "overrides": [] },
      "targets": [
        {
          "refId": "A",
          "expr": "histogram_quantile(0.95, sum(rate(http_server_request_duration_seconds_bucket[2m])) by (le, service_name))",
          "legendFormat": "{{service_name}}"
        }
      ]
    },
    {
      "id": 5,
      "type": "logs",
      "title": "WARNING / ERROR ログ",
      "gridPos": { "x": 0, "y": 16, "w": 16, "h": 9 },
      "datasource": { "type": "loki", "uid": "loki" },
      "options": {
        "showTime": true,
        "sortOrder": "Descending",
        "wrapLogMessage": true
      },
      "targets": [
        {
          "refId": "A",
          "expr": "{service_name=~\"job-api|slot-manager\"} | detected_level=~\"warn|error\"",
          "queryType": "range"
        }
      ]
    },
    {
      "id": 6,
      "type": "stat",
      "title": "スクレイプ対象 up",
      "gridPos": { "x": 16, "y": 16, "w": 8, "h": 9 },
      "datasource": { "type": "prometheus", "uid": "prometheus" },
      "fieldConfig": {
        "defaults": {
          "thresholds": {
            "mode": "absolute",
            "steps": [
              { "color": "red", "value": null },
              { "color": "green", "value": 1 }
            ]
          }
        },
        "overrides": []
      },
      "options": {
        "reduceOptions": { "calcs": ["lastNotNull"] },
        "textMode": "value_and_name"
      },
      "targets": [{ "refId": "A", "expr": "up", "legendFormat": "{{job}}" }]
    }
  ]
}
litellm/config.yaml Claude Code からローカル LLM への変換(記事の計測では未使用)
# ローカル LLM を Claude Code から使うための変換プロキシ。
# Claude Code は Anthropic Messages API(/v1/messages)を話すので、LiteLLM で受けて
# OpenAI 互換の llama.cpp(既存スタックの :8099)へ流す。
#   claude 側: ANTHROPIC_BASE_URL=http://localhost:4000  ANTHROPIC_AUTH_TOKEN=sk-local  --model qwen3.6-35b-a3b
model_list:
  - model_name: qwen3.6-35b-a3b
    litellm_params:
      model: openai/qwen3.6-35b-a3b
      api_base: http://host.docker.internal:8099/v1
      api_key: none
      timeout: 600

litellm_settings:
  drop_params: true
  set_verbose: false

general_settings:
  master_key: sk-local
監視対象(app/)
app/Dockerfile
FROM python:3.13-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY . .
app/requirements.txt
fastapi
uvicorn
httpx
opentelemetry-sdk
opentelemetry-exporter-otlp-proto-grpc
opentelemetry-instrumentation-fastapi
opentelemetry-instrumentation-httpx
app/telemetry.py OTLP の配線。トレース・メトリクス・ログをまとめて Collector へ
"""OTel の配線。トレース・メトリクス・ログをまとめて OTLP(gRPC)で Collector に送る。

送り先は環境変数 OTEL_EXPORTER_OTLP_ENDPOINT(compose では otel-collector:4317)。
ログは標準 logging に LoggingHandler を足すだけで、trace_id / span_id が自動で付く。
"""

from __future__ import annotations

import logging
import os
import socket

from opentelemetry import metrics, trace
from opentelemetry._logs import set_logger_provider
from opentelemetry.exporter.otlp.proto.grpc._log_exporter import OTLPLogExporter
from opentelemetry.exporter.otlp.proto.grpc.metric_exporter import OTLPMetricExporter
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.sdk._logs import LoggerProvider, LoggingHandler
from opentelemetry.sdk._logs.export import BatchLogRecordProcessor
from opentelemetry.sdk.metrics import MeterProvider
from opentelemetry.sdk.metrics.export import PeriodicExportingMetricReader
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor


def setup(service_name: str) -> tuple[trace.Tracer, metrics.Meter]:
    resource = Resource.create({
        "service.name": service_name,
        "service.version": os.environ.get("APP_VERSION", "0.1.0"),
        "service.instance.id": socket.gethostname(),
    })

    tp = TracerProvider(resource=resource)
    tp.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
    trace.set_tracer_provider(tp)

    mp = MeterProvider(
        resource=resource,
        metric_readers=[PeriodicExportingMetricReader(OTLPMetricExporter(), export_interval_millis=5000)],
    )
    metrics.set_meter_provider(mp)

    lp = LoggerProvider(resource=resource)
    lp.add_log_record_processor(BatchLogRecordProcessor(OTLPLogExporter()))
    set_logger_provider(lp)

    # 標準出力(docker logs)にも同じ行を出す
    logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(name)s: %(message)s")
    logging.getLogger().addHandler(LoggingHandler(level=logging.NOTSET, logger_provider=lp))

    return trace.get_tracer(service_name), metrics.get_meter(service_name)
app/job_api.py ジョブの受付。slot-manager を呼ぶ
"""job-api サービス。計算ジョブの投入を受けて slot-manager に計算枠の確保を頼む。

- POST /jobs {"user", "job", "size"}: slot-manager の /reserve を呼び、結果を返す。
  メトリクス jobs(結末別の件数)と jobs.duration(所要秒)を記録する
- POST /admin/fault: 故障注入。{"duplicate_calls": 8} で 1 ジョブあたり /reserve を 8 回呼ぶ(冪等でない再送のバグ)。
  {"reset": true} で戻す
- GET /admin/fault、GET /health

メトリクスのラベルは outcome(ok / failed)だけ。ジョブ種別やエラー内容はログとスパン属性にだけ出る。
"""

from __future__ import annotations

import itertools
import logging
import os
import time

import httpx
from fastapi import FastAPI
from fastapi.responses import JSONResponse
from opentelemetry import trace
from opentelemetry.instrumentation.fastapi import FastAPIInstrumentor
from opentelemetry.instrumentation.httpx import HTTPXClientInstrumentor

import telemetry

tracer, meter = telemetry.setup("job-api")
log = logging.getLogger("job-api")

app = FastAPI(title="job-api")
FastAPIInstrumentor.instrument_app(app, excluded_urls="health,admin")
HTTPXClientInstrumentor().instrument()

SLOT_MANAGER_URL = os.environ.get("SLOT_MANAGER_URL", "http://slot-manager:8000").rstrip("/")
FAULT: dict[str, int] = {"duplicate_calls": 1}
# 種別ごとの見積もり時間(秒)。ログに載せるだけ
ESTIMATE_S = {"mip": 600, "lp": 60, "simulation": 300, "ml": 1800}

jobs_counter = meter.create_counter("jobs", description="ジョブ投入の結末別の件数")
jobs_duration = meter.create_histogram(
    "jobs.duration", unit="s", description="ジョブ投入 1 件の所要時間(枠の確保まで)",
    explicit_bucket_boundaries_advisory=[0.01, 0.025, 0.05, 0.1, 0.25, 0.5, 1, 2.5, 5, 10],
)
_seq = itertools.count(1000)
_client = httpx.AsyncClient(timeout=30.0, limits=httpx.Limits(max_connections=200, max_keepalive_connections=50))


@app.post("/jobs")
async def submit_job(body: dict):
    t0 = time.perf_counter()
    job_id = f"J-{next(_seq)}"
    job = body.get("job", "")
    size = int(body.get("size", 1))
    user = body.get("user", "anonymous")
    attrs = {"job.id": job_id, "user.id": user, "job.type": job, "job.size": size}
    span = trace.get_current_span()
    for k, v in attrs.items():
        span.set_attribute(k, v)
    log.info("job received", extra=attrs)

    outcome, status, detail = "ok", 200, None
    try:
        for _ in range(max(1, FAULT["duplicate_calls"])):
            r = await _client.post(f"{SLOT_MANAGER_URL}/reserve", json={"job": job, "size": size})
        if r.status_code != 200:
            outcome, status = "failed", r.status_code
            try:
                detail = r.json().get("error", r.text)
            except ValueError:
                detail = r.text
    except httpx.HTTPError as e:
        outcome, status, detail = "failed", 502, f"slot-manager unreachable: {type(e).__name__}: {e}"

    elapsed = time.perf_counter() - t0
    jobs_counter.add(1, {"outcome": outcome})
    jobs_duration.record(elapsed, {"outcome": outcome})
    span.set_attribute("job.outcome", outcome)

    if outcome == "ok":
        log.info("job submitted", extra={**attrs, "job.estimate_s": ESTIMATE_S.get(job, 0)})
        return {"job_id": job_id, "job": job, "size": size, "estimate_s": ESTIMATE_S.get(job, 0)}
    log.error("job failed: %s", detail, extra={**attrs, "http.response.status_code": status})
    return JSONResponse({"job_id": job_id, "error": detail}, status_code=status)


@app.get("/health")
async def health():
    return {"status": "ok"}


@app.get("/admin/fault")
async def get_fault():
    return {"fault": FAULT, "slot_manager_url": SLOT_MANAGER_URL}


@app.post("/admin/fault")
async def set_fault(body: dict):
    if body.get("reset"):
        FAULT["duplicate_calls"] = 1
    if "duplicate_calls" in body:
        FAULT["duplicate_calls"] = int(body["duplicate_calls"])
    return await get_fault()
app/slot_manager.py 計算枠 DB アクセスを sleep と接続プールで模擬
"""slot-manager サービス。計算ジョブごとに計算枠(ライセンス席、GPU/CPU スロット)を確保する。job-api の下流。

- POST /reserve {"job", "size"}: 枠を確認して確保する。 DB へのアクセスは sleep で模擬し、
  接続プール(DB_POOL 本)を取り合う。プール待ちは db.pool.acquire、問い合わせは db.query のスパンになる
- POST /admin/fault: 故障注入。{"latency_ms": 300} で DB を遅くする、{"slots": {"mip": 0}} で枠数を書き換える、
  {"error_rate": 0.5} で DB エラーを混ぜる。{"reset": true} で全部戻す
- GET /admin/fault: 現在の故障設定
- GET /health

枠切れは 409 とエラーログ「failed to reserve: no free slot: <job>」で表す。
メトリクスにはジョブ種別のラベルを付けない(どの種別かはログにしか出ない)。
"""

from __future__ import annotations

import asyncio
import logging
import os
import random

from fastapi import FastAPI
from fastapi.responses import JSONResponse
from opentelemetry.instrumentation.fastapi import FastAPIInstrumentor

import telemetry

tracer, meter = telemetry.setup("slot-manager")
log = logging.getLogger("slot-manager")

app = FastAPI(title="slot-manager")
FastAPIInstrumentor.instrument_app(app, excluded_urls="health,admin")

BIG = 10**9
JOB_TYPES = ("mip", "lp", "simulation", "ml")
SLOTS: dict[str, int] = {job: BIG for job in JOB_TYPES}
FAULT: dict[str, float] = {"latency_ms": 0, "error_rate": 0.0}
DB_BASE_MS = int(os.environ.get("DB_BASE_MS", "40"))
DB_POOL = int(os.environ.get("DB_POOL", "4"))
LOW_WATERMARK = 50

_pool = asyncio.Semaphore(DB_POOL)


async def db_query(operation: str) -> None:
    """DB 呼び出しの模擬。プール待ちと問い合わせ本体を別のスパンにする。"""
    with tracer.start_as_current_span("db.pool.acquire"):
        await _pool.acquire()
    try:
        with tracer.start_as_current_span("db.query") as span:
            span.set_attribute("db.system.name", "sqlite")
            span.set_attribute("db.operation.name", operation)
            await asyncio.sleep((DB_BASE_MS + FAULT["latency_ms"]) / 1000)
    finally:
        _pool.release()


@app.post("/reserve")
async def reserve(body: dict):
    job = body.get("job", "")
    size = int(body.get("size", 1))
    if job not in SLOTS:
        return JSONResponse({"error": f"unknown job type: {job}"}, status_code=400)

    await db_query("SELECT slots")
    if random.random() < FAULT["error_rate"]:
        log.error("db connection reset while reserving", extra={"job.type": job})
        return JSONResponse({"error": "db error"}, status_code=500)
    if SLOTS[job] < size:
        log.error(
            "failed to reserve: no free slot: %s", job,
            extra={"job.type": job, "job.size": size, "slots.remaining": SLOTS[job]},
        )
        return JSONResponse({"error": "no free slot"}, status_code=409)

    SLOTS[job] -= size
    await db_query("UPDATE slots")
    log.info("reserved: %s x%d", job, size, extra={"job.type": job, "job.size": size, "slots.remaining": SLOTS[job]})
    if SLOTS[job] < LOW_WATERMARK:
        log.warning(
            "slots running low: %s", job,
            extra={"job.type": job, "slots.remaining": SLOTS[job]},
        )
    return {"job": job, "remaining": SLOTS[job]}


@app.get("/health")
async def health():
    return {"status": "ok"}


@app.get("/admin/fault")
async def get_fault():
    return {"fault": FAULT, "slots": {k: v for k, v in SLOTS.items()}, "db_base_ms": DB_BASE_MS, "db_pool": DB_POOL}


@app.post("/admin/fault")
async def set_fault(body: dict):
    if body.get("reset"):
        FAULT.update({"latency_ms": 0, "error_rate": 0.0})
        for job in JOB_TYPES:
            SLOTS[job] = BIG
    if "latency_ms" in body:
        FAULT["latency_ms"] = float(body["latency_ms"])
    if "error_rate" in body:
        FAULT["error_rate"] = float(body["error_rate"])
    for job, n in (body.get("slots") or {}).items():
        if job in SLOTS:
            SLOTS[job] = int(n)
    return await get_fault()
受け口とエージェント
investigate.py Alertmanager の webhook を受けて claude -p(または local_agent.py)を起動し、レポート・annotation・Mattermost 投稿を行う
"""Alertmanager の webhook を受けて Claude Code(headless)に調査させる受け口。

- POST /alert に Alertmanager の webhook ペイロードが届く
- firing のアラートごとに `claude -p` を起動し、Grafana MCP(読み取り専用。Prometheus / Loki / Tempo)で調べさせる
- 結果を reports/ に Markdown で保存し、Grafana の annotation に書き戻す

自作するのはこのファイルだけ。標準ライブラリのみで動く。
"""

from __future__ import annotations

import base64
import json
import os
import shlex
import subprocess
import sys
import threading
import time
import urllib.error
import urllib.request
from datetime import datetime, timezone
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from pathlib import Path

HERE = Path(__file__).resolve().parent
PORT = int(os.environ.get("PORT", "9095"))
CLAUDE_BIN = os.environ.get("CLAUDE_BIN", "claude")
CLAUDE_MODEL = os.environ.get("CLAUDE_MODEL", "sonnet")
MCP_CONFIG = os.environ.get("MCP_CONFIG", str(HERE / "mcp.json"))
PROMPT_FILE = os.environ.get("PROMPT_FILE", str(HERE / "PROMPT.md"))
REPORT_DIR = Path(os.environ.get("REPORT_DIR", str(HERE / "reports")))
GRAFANA_URL = os.environ.get("GRAFANA_URL", "http://localhost:3082").rstrip("/")
GRAFANA_SA_TOKEN = os.environ.get("GRAFANA_SA_TOKEN", "")
# トークンが無ければ基本認証(実験用。既定は admin:admin)
GRAFANA_BASIC_AUTH = os.environ.get("GRAFANA_BASIC_AUTH", "admin:admin")
# エージェントに許すツール。mcp-grafana の MCP だけ(Tempo のツールも mcp-grafana が tempo_* として中継する)
ALLOWED_TOOLS = os.environ.get("ALLOWED_TOOLS", "mcp__grafana__*")
# 同じアラート(fingerprint)はこの秒数の間は再調査しない
DEDUP_SECONDS = int(os.environ.get("DEDUP_SECONDS", "1800"))
# Mattermost の incoming webhook。未設定なら .env の MATTERMOST_HOOK_ID から組み立てる(setup_mattermost.py が書く)
MATTERMOST_URL = os.environ.get("MATTERMOST_URL", "http://localhost:8065").rstrip("/")
MATTERMOST_WEBHOOK_URL = os.environ.get("MATTERMOST_WEBHOOK_URL", "")
# 投稿先チャンネル。モデルごとに分けるときは受け口の起動時に変える(例: sonnet / qwen)
MATTERMOST_CHANNEL = os.environ.get("MATTERMOST_CHANNEL", "alerts")
MATTERMOST_MAX_CHARS = 16000  # Mattermost の投稿上限は 16,383 文字
# Claude Code の組み込みツール。エージェントには MCP ツールだけを残す
BUILTIN_TOOLS = "Bash,PowerShell,Edit,Write,MultiEdit,NotebookEdit,Read,Glob,Grep,LS,WebFetch,WebSearch,Agent,TodoWrite,Skill"

_recent: dict[str, float] = {}
_lock = threading.Lock()


def log(msg: str) -> None:
    print(f"[{datetime.now().strftime('%H:%M:%S')}] {msg}", flush=True)


def build_prompt(alert: dict) -> str:
    template = Path(PROMPT_FILE).read_text(encoding="utf-8")
    return template.replace("{alert_json}", json.dumps(alert, ensure_ascii=False, indent=2))


def run_claude(prompt: str) -> dict:
    """claude -p を起動して JSON 結果を返す。組み込みツールは拒否し、MCP ツールだけ許可する。"""
    cmd = [
        *shlex.split(CLAUDE_BIN, posix=(os.name != "nt")),
        "-p",
        "--model", CLAUDE_MODEL,
        "--output-format", "json",
        "--mcp-config", MCP_CONFIG,
        "--strict-mcp-config",
        "--allowedTools", ALLOWED_TOOLS,
        # 組み込みツールは名前で全部拒否する(--tools "" だと MCP ツールの許可まで消える)
        "--disallowedTools", BUILTIN_TOOLS,
        "--no-session-persistence",
    ]
    started = time.monotonic()
    proc = subprocess.run(cmd, input=prompt, capture_output=True, text=True, encoding="utf-8")
    elapsed = time.monotonic() - started
    try:
        data = json.loads(proc.stdout)
    except json.JSONDecodeError:
        data = None
    if proc.returncode != 0 and not (isinstance(data, dict) and data.get("result")):
        raise RuntimeError(f"claude exited {proc.returncode}: {proc.stderr[-1500:]} {proc.stdout[-1500:]}")
    if proc.returncode != 0:
        # API エラーなどで途中終了しても、結果(エラー文)を残す。ローカルモデルのコンテキスト超過の記録用
        log(f"claude exited {proc.returncode}(結果は保存する): {str(data.get('result'))[:200]}")
        data["is_error"] = True
    data.setdefault("duration_ms", int(elapsed * 1000))
    data["_stderr"] = proc.stderr
    return data


def grafana_auth_header() -> str:
    if GRAFANA_SA_TOKEN:
        return f"Bearer {GRAFANA_SA_TOKEN}"
    return "Basic " + base64.b64encode(GRAFANA_BASIC_AUTH.encode("utf-8")).decode("ascii")


def post_annotation(alert: dict, report_text: str) -> None:
    labels = alert.get("labels", {})
    started = alert.get("startsAt", "")
    try:
        t = int(datetime.fromisoformat(started.replace("Z", "+00:00")).timestamp() * 1000)
    except ValueError:
        t = int(time.time() * 1000)
    body = {
        "time": t,
        "tags": ["ai-investigation", labels.get("alertname", "unknown")],
        "text": f"[{labels.get('alertname')}] AI 調査\n\n" + report_text[:1500],
    }
    req = urllib.request.Request(
        f"{GRAFANA_URL}/api/annotations",
        data=json.dumps(body).encode("utf-8"),
        headers={
            "Content-Type": "application/json",
            "Authorization": grafana_auth_header(),
        },
        method="POST",
    )
    try:
        with urllib.request.urlopen(req, timeout=10) as resp:
            log(f"annotation 作成: HTTP {resp.status}")
    except urllib.error.URLError as e:
        log(f"annotation 作成に失敗: {e}")


def mattermost_webhook_url() -> str:
    if MATTERMOST_WEBHOOK_URL:
        return MATTERMOST_WEBHOOK_URL
    env = HERE / ".env"
    if env.exists():
        for line in env.read_text(encoding="utf-8").splitlines():
            if line.startswith("MATTERMOST_HOOK_ID="):
                return f"{MATTERMOST_URL}/hooks/{line.split('=', 1)[1].strip()}"
    return ""


def post_mattermost(alert: dict, report_text: str, result: dict) -> None:
    """調査レポートの全文を Mattermost の #alerts に投稿する(Markdown はそのまま描画される)"""
    url = mattermost_webhook_url()
    if not url:
        log("Mattermost の webhook が未設定なので投稿しない")
        return
    labels = alert.get("labels", {})
    head = (f"### [{labels.get('alertname')}] AI 調査レポート\n"
            f"発火 {alert.get('startsAt', '')} / モデル {CLAUDE_MODEL} / "
            f"所要 {result.get('duration_ms', 0) / 1000:.0f} 秒、{result.get('num_turns')} ターン\n\n")
    text = head + report_text
    if len(text) > MATTERMOST_MAX_CHARS:
        text = text[:MATTERMOST_MAX_CHARS] + "\n\n…(上限のため省略)"
    body = {"channel": MATTERMOST_CHANNEL, "username": f"ai-investigator ({CLAUDE_MODEL})", "text": text}
    req = urllib.request.Request(url, data=json.dumps(body, ensure_ascii=False).encode("utf-8"),
                                 headers={"Content-Type": "application/json"}, method="POST")
    try:
        with urllib.request.urlopen(req, timeout=10) as resp:
            log(f"Mattermost 投稿: HTTP {resp.status}")
    except (urllib.error.URLError, OSError) as e:
        log(f"Mattermost 投稿に失敗: {e}")


def investigate(alert: dict) -> None:
    labels = alert.get("labels", {})
    name = labels.get("alertname", "unknown")
    stamp = datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%SZ")
    log(f"調査開始: {name} {labels}")
    try:
        result = run_claude(build_prompt(alert))
    except Exception as e:  # noqa: BLE001
        log(f"調査失敗: {name}: {e}")
        return
    report = result.get("result", "")
    REPORT_DIR.mkdir(parents=True, exist_ok=True)
    path = REPORT_DIR / f"{stamp}_{name}.md"
    header = (
        f"# {name}\n\n"
        f"- 開始: {alert.get('startsAt')}\n"
        f"- ラベル: `{json.dumps(labels, ensure_ascii=False)}`\n"
        f"- モデル: {CLAUDE_MODEL}\n"
        f"- 所要: {result.get('duration_ms', 0) / 1000:.1f} 秒、ターン数: {result.get('num_turns')}\n\n"
    )
    path.write_text(header + report + "\n", encoding="utf-8")
    if result.get("_stderr"):
        # エージェントの標準エラー(local_agent.py ならツール呼び出しの記録)を並べて残す
        path.with_suffix(".log").write_text(result["_stderr"], encoding="utf-8")
    with (REPORT_DIR / "results.jsonl").open("a", encoding="utf-8") as f:
        f.write(json.dumps({
            "time": stamp,
            "alertname": name,
            "model": CLAUDE_MODEL,
            "duration_ms": result.get("duration_ms"),
            "num_turns": result.get("num_turns"),
            "is_error": bool(result.get("is_error")),
            "usage": result.get("usage"),
            "report": str(path.name),
        }, ensure_ascii=False) + "\n")
    log(f"レポート保存: {path}")
    post_annotation(alert, report)
    post_mattermost(alert, report, result)


class Handler(BaseHTTPRequestHandler):
    def do_POST(self) -> None:  # noqa: N802
        if self.path != "/alert":
            self.send_error(404)
            return
        length = int(self.headers.get("Content-Length", "0"))
        try:
            payload = json.loads(self.rfile.read(length) or b"{}")
        except json.JSONDecodeError:
            self.send_error(400, "invalid json")
            return
        self.send_response(200)
        self.end_headers()
        now = time.time()
        for alert in payload.get("alerts", []):
            if alert.get("status") != "firing":
                continue
            key = alert.get("fingerprint") or json.dumps(alert.get("labels", {}), sort_keys=True)
            with _lock:
                if now - _recent.get(key, 0) < DEDUP_SECONDS:
                    log(f"スキップ(直近に調査済み): {alert.get('labels', {}).get('alertname')}")
                    continue
                _recent[key] = now
            threading.Thread(target=investigate, args=(alert,), daemon=True).start()

    def log_message(self, fmt: str, *args) -> None:  # noqa: D102
        return


def main() -> None:
    if hasattr(sys.stdout, "reconfigure"):
        sys.stdout.reconfigure(encoding="utf-8")  # Windows のコンソールでも日本語ログを崩さない
    server = ThreadingHTTPServer(("0.0.0.0", PORT), Handler)
    log(f"受け口を起動: http://0.0.0.0:{PORT}/alert (claude={CLAUDE_BIN}, model={CLAUDE_MODEL}, tools={ALLOWED_TOOLS})")
    try:
        server.serve_forever()
    except KeyboardInterrupt:
        pass


if __name__ == "__main__":
    sys.exit(main())
setup_mattermost.py Mattermost の初期設定(管理者、チーム、チャンネル、incoming webhook)
"""Mattermost の初期設定(標準ライブラリのみ)。

    python setup_mattermost.py [--url http://localhost:8065] [--admin-password ...]

1. 最初のユーザー(= システム管理者)admin を作る
2. チーム ops とチャンネル alerts を作る
3. alerts への incoming webhook を作る
4. webhook の id を .env(MATTERMOST_HOOK_ID)に書き、alertmanager/alertmanager.tmpl.yml から alertmanager/alertmanager.yml を生成する

再実行しても既存のものを使い回す(冪等)。終わったら `docker compose restart alertmanager` で通知先を反映する。
"""

from __future__ import annotations

import argparse
import json
import re
import sys
import time
import urllib.error
import urllib.request
from pathlib import Path

HERE = Path(__file__).resolve().parent


def api(base: str, method: str, path: str, body: dict | None = None, token: str | None = None):
    req = urllib.request.Request(f"{base}/api/v4{path}", method=method,
                                 data=json.dumps(body).encode("utf-8") if body is not None else None,
                                 headers={"Content-Type": "application/json"})
    if token:
        req.add_header("Authorization", f"Bearer {token}")
    try:
        with urllib.request.urlopen(req, timeout=30) as resp:
            raw = resp.read()
            return resp.status, (json.loads(raw) if raw else None), resp.headers
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}"), e.headers


def wait_ready(base: str) -> None:
    for _ in range(60):
        try:
            with urllib.request.urlopen(f"{base}/api/v4/system/ping", timeout=5) as resp:
                if resp.status == 200:
                    return
        except (urllib.error.URLError, TimeoutError, OSError):
            pass
        time.sleep(3)
    raise SystemExit("Mattermost が起動しない")


def main() -> int:
    p = argparse.ArgumentParser()
    p.add_argument("--url", default="http://localhost:8065")
    p.add_argument("--admin-user", default="admin")
    p.add_argument("--admin-password", default="Admin-pass-1234")
    p.add_argument("--admin-email", default="admin@example.invalid")
    p.add_argument("--team", default="ops")
    p.add_argument("--channel", default="alerts")
    a = p.parse_args()
    base = a.url.rstrip("/")
    wait_ready(base)

    # 1. 管理者(最初のユーザーがシステム管理者になる)
    status, body, _ = api(base, "POST", "/users", {"email": a.admin_email, "username": a.admin_user, "password": a.admin_password})
    print(f"user: {status} {body.get('username') if isinstance(body, dict) else body}")
    status, body, headers = api(base, "POST", "/users/login", {"login_id": a.admin_user, "password": a.admin_password})
    if status != 200:
        raise SystemExit(f"login failed: {status} {body}")
    token = headers["Token"]

    # 2. チームとチャンネル
    status, team, _ = api(base, "GET", f"/teams/name/{a.team}", token=token)
    if status != 200:
        status, team, _ = api(base, "POST", "/teams", {"name": a.team, "display_name": a.team.capitalize(), "type": "O"}, token=token)
    print(f"team: {team['name']} ({team['id']})")
    status, ch, _ = api(base, "GET", f"/teams/{team['id']}/channels/name/{a.channel}", token=token)
    if status != 200:
        status, ch, _ = api(base, "POST", "/channels", {"team_id": team["id"], "name": a.channel, "display_name": a.channel, "type": "O"}, token=token)
    print(f"channel: {ch['name']} ({ch['id']})")

    # 3. incoming webhook(display_name で既存を探す)
    status, hooks, _ = api(base, "GET", f"/hooks/incoming?team_id={team['id']}&per_page=200", token=token)
    hook = next((h for h in (hooks or []) if h.get("display_name") == "alert-investigation"), None)
    if not hook:
        status, hook, _ = api(base, "POST", "/hooks/incoming", {
            "channel_id": ch["id"], "display_name": "alert-investigation",
            "description": "Alertmanager の発火通知と AI 調査レポート",
        }, token=token)
    print(f"webhook: {hook['id']}")

    # 4. .env と alertmanager.yml
    env_path = HERE / ".env"
    lines = env_path.read_text(encoding="utf-8").splitlines() if env_path.exists() else []
    lines = [l for l in lines if not l.startswith("MATTERMOST_HOOK_ID=")]
    lines.append(f"MATTERMOST_HOOK_ID={hook['id']}")
    env_path.write_text("\n".join(lines) + "\n", encoding="utf-8")
    tmpl = (HERE / "alertmanager" / "alertmanager.tmpl.yml").read_text(encoding="utf-8")
    (HERE / "alertmanager" / "alertmanager.yml").write_text(tmpl.replace("{{MATTERMOST_HOOK_ID}}", hook["id"]), encoding="utf-8")
    print(f"wrote .env and alertmanager/alertmanager.yml. next: docker compose restart alertmanager")
    print(f"login: {base}  user={a.admin_user}  channel=~{a.channel}")
    return 0


if __name__ == "__main__":
    sys.exit(main())
PROMPT.md 調査プロンプト(v2)
あなたは Grafana に接続された SRE の調査エージェントです。
Alertmanager から次のアラートが届きました。

```json
{alert_json}
```

監視対象は計算ジョブの投入システムで、`job-api` と `slot-manager` の 2 サービスからなります。
`job-api` はジョブ 1 件ごとに `slot-manager` の `POST /reserve` を呼び、`slot-manager` は DB で計算枠を確認して確保します。
3 つのデータソースが使えます。

- Prometheus(メトリクス): `jobs_total{outcome}`、`jobs_duration_seconds_bucket` など。`mcp__grafana__query_prometheus`
- Loki(ログ): `{service_name="job-api"}`、`{service_name="slot-manager"}`。`mcp__grafana__query_loki_logs`
- Tempo(トレース): `mcp__grafana__tempo_traceql-search` と `mcp__grafana__tempo_get-trace`

MCP ツール(`mcp__grafana__*`)だけを使って原因を調べてください。
ツールは読み取り専用です。設定変更や書き込みはできません。

クエリの書き方:

- PromQL の時間範囲は `startsAt` の前後 30 分。range クエリには `stepSeconds=60` を渡す
- LogQL は 1 本のストリームにフィルタを足す(例: `{service_name="slot-manager"} |~ "(?i)error|warn"`)。`or` で 2 本をつながない
- TraceQL の例: `{resource.service.name="job-api" && duration > 500ms}`。検索には開始・終了時刻を必ず渡す
- ツールがエラーを返したら、クエリを 1 度だけ書き直すか別の手段に切り替える

手順:

1. `query_prometheus` でアラート式そのものと、関連するメトリクスをアラートの `startsAt` の前後 30 分で確認する
2. 仮説を 2〜3 個立て、それぞれをクエリで検証する
3. メトリクスで原因が閉じないときは、`startsAt` の前後 5 分のログとトレースを見る
   - ログ: `query_loki_logs` で `startsAt` 前後の ERROR / WARNING 行を引き、原因を示す行をそのまま引用する
   - トレース: `tempo_traceql-search` で遅い、または失敗したトレースを探し、`tempo_get-trace` でどのサービスのどのスパンが時間を使っているかを見る
4. `get_annotations` で直近のデプロイや過去の調査結果があれば参照する

調べ方の原則:

- エラーの原因は、エラーを返した側(下流のサービス)のログから引く。呼び出し側に残る HTTP ステータス(409 や 502)は結果であって原因ではない
- 失敗が一部に偏っていないか(種別・対象・ユーザーなど)を、ログの属性で集計して確かめる。偏りがあれば、その値を結論に書く
- 過去の調査結果(annotation)は参考に留める。今回のアラートの時間帯のデータで確認できたことだけを根拠にし、過去の障害を今回の原因に流用しない

回答は日本語で、次の見出し構成の Markdown にしてください。

## 症状

アラートの内容と、実際に観測した値(数字と時刻を含める)。

## 仮説と検証

| #   | 仮説 | 検証に使ったクエリ | 結果 | 判定 |
| --- | ---- | ------------------ | ---- | ---- |

## 結論

最も可能性の高い原因を 1〜3 行で。確信度(高 / 中 / 低)を添える。
根拠にしたログ行やスパン名があれば、そのまま引用する。

## 次の一手

運用者が取るべき行動を箇条書きで 3 つまで。
mcp.json Claude Code に渡す MCP サーバ定義
{
  "mcpServers": {
    "grafana": {
      "type": "http",
      "url": "http://localhost:8097/mcp"
    }
  }
}
local_agent.py ローカル LLM 用の最小エージェント
"""ローカル LLM 用の最小エージェント。受け口(investigate.py)から `claude -p` の代わりに呼ぶ。

    uv run --no-project --with mcp --with openai python local_agent.py \
        --model qwen3.6-35b-a3b --mcp-config mcp.json [--allowedTools ...]

- stdin にプロンプト、stdout に `claude --output-format json` と同じ形の JSON を返す
- MCP サーバ(mcp.json の先頭)に Streamable HTTP でつなぎ、ツール一覧を OpenAI 互換の function calling に変換する
- LLM は OpenAI 互換 API(既定 http://localhost:8099/v1、llama.cpp)。ツール呼び出しがなくなるまで回す
- コンテキストが小さいので、ツールの結果は LOCAL_MAX_TOOL_CHARS で切り詰め、
  prompt_tokens が LOCAL_COMPACT_AT を超えたら古いツール結果を短くする

Claude Code のシステムプロンプト(約 18k トークン)を持たないので、同じ 32k のモデルでも調査が最後まで回る。
受け口の CLAUDE_BIN に "uv run --no-project --with mcp --with openai python local_agent.py" を入れると差し替わる。
"""

from __future__ import annotations

import argparse
import asyncio
import json
import os
import sys
import time

from mcp import ClientSession
from openai import OpenAI

try:  # mcp SDK の版で名前が違う
    from mcp.client.streamable_http import streamable_http_client as streamablehttp_client
except ImportError:  # pragma: no cover
    from mcp.client.streamable_http import streamablehttp_client

LLM_BASE = os.environ.get("LOCAL_LLM_BASE", "http://localhost:8099/v1")
MAX_TURNS = int(os.environ.get("LOCAL_MAX_TURNS", "30"))
# 既定は llama.cpp 64k 向け(ツール 20 回 / 結果 6,000 文字 / 52k で圧縮)。32k なら 14 / 3000 / 24000 にする
MAX_TOOL_CALLS = int(os.environ.get("LOCAL_MAX_TOOL_CALLS", "20"))
MAX_TOOL_CHARS = int(os.environ.get("LOCAL_MAX_TOOL_CHARS", "6000"))
COMPACT_AT = int(os.environ.get("LOCAL_COMPACT_AT", "52000"))
KEEP_RECENT = int(os.environ.get("LOCAL_KEEP_RECENT", "4"))
TOOL_ALLOW = [t for t in os.environ.get("LOCAL_TOOLS", "").split(",") if t]

# 枠組みの説明だけを書く。調査の手順やクエリの書き方は Claude Code と共通の PROMPT.md に置く
SYSTEM = (
    "ツールは 1 回に 1 つずつ呼び、結果を読んでから次を決めてください。"
    f"ツール呼び出しは合計 {MAX_TOOL_CALLS} 回までです。各結果の末尾に残り回数を示します。"
    "残りが少なくなったら、手元の事実で報告を書いてください。"
    "tempo_get-trace の結果は「service | span | duration_ms | detail」の表で返ります。"
)


def log(msg: str) -> None:
    print(f"[local_agent] {msg}", file=sys.stderr, flush=True)


def to_openai_tool(t) -> dict:
    schema = (getattr(t, "input_schema", None) or getattr(t, "inputSchema", None)
              or {"type": "object", "properties": {}})
    return {"type": "function", "function": {
        "name": t.name,
        "description": (t.description or "")[:800],
        "parameters": schema,
    }}


def shape_result(name: str, text: str) -> str:
    """大きな JSON を小さなモデル向けに要約する。Tempo の検索結果とトレースが対象。他はそのまま返す"""
    if not text.lstrip().startswith("{"):
        return text
    try:
        data = json.loads(text)
    except json.JSONDecodeError:
        return text
    if name.endswith("traceql-search") and isinstance(data.get("traces"), list):
        lines = ["traceID | root service | root span | duration_ms"]
        for t in data["traces"][:15]:
            lines.append(f"{t.get('traceID')} | {t.get('rootServiceName')} | {t.get('rootTraceName')} | {t.get('durationMs')}")
        lines.append(f"({len(data['traces'])} traces。詳細は tempo_get-trace で 1 件ずつ)")
        return "\n".join(lines)
    if name.endswith("get-trace") and isinstance(data.get("trace"), dict):
        rows = []
        for svc in data["trace"].get("services", []):
            for scope in svc.get("scopes", []):
                for sp in scope.get("spans", []):
                    a = sp.get("attributes", {}) or {}
                    detail = a.get("db.operation.name") or a.get("http.route") or a.get("url.full") or ""
                    status = sp.get("status", {}).get("code", "")
                    err = " ERROR" if "ERROR" in status else ""
                    rows.append((int(sp.get("startTimeUnixNano", 0)), svc.get("serviceName"), sp.get("name"),
                                 float(sp.get("durationMs", 0)), detail, err,
                                 a.get("http.response.status_code", "")))
        rows.sort()
        lines = [f"trace {data['trace'].get('traceId')} : service | span | duration_ms | detail"]
        for _, s, n, d, detail, err, code in rows[:40]:
            lines.append(f"{s} | {n} | {d:.1f} | {detail} {code}{err}".rstrip())
        if len(rows) > 40:
            lines.append(f"(全 {len(rows)} スパンのうち先頭 40)")
        return "\n".join(lines)
    return text


def compact(messages: list[dict]) -> int:
    """古いツール結果を短くしてコンテキストを空ける。最近の KEEP_RECENT 件は残す"""
    idx = [i for i, m in enumerate(messages) if m["role"] == "tool" and not m.get("_compacted")]
    n = 0
    for i in idx[:-KEEP_RECENT] if len(idx) > KEEP_RECENT else []:
        m = messages[i]
        if len(m["content"]) > 300:
            m["content"] = m["content"][:300] + "…(古い結果なので省略)"
            m["_compacted"] = True
            n += 1
    return n


def dedupe_paragraphs(text: str) -> str:
    """反復ループで同じ段落が並んだ出力を、初出だけ残して畳む(判定のため元の長さは注記する)"""
    paras = text.split("\n\n")
    out, seen = [], set()
    for p in paras:
        k = p.strip()
        if k and k in seen:
            continue
        seen.add(k)
        out.append(p)
    if len(out) < len(paras):
        out.append(f"\n(同じ段落の繰り返し {len(paras) - len(out)} 個を省略)")
    return "\n\n".join(out)


def strip_private(messages: list[dict]) -> list[dict]:
    return [{k: v for k, v in m.items() if not k.startswith("_")} for m in messages]


async def run(model: str, mcp_url: str, prompt: str) -> dict:
    t0 = time.monotonic()
    usage = {"input_tokens": 0, "output_tokens": 0}
    tool_log: list[str] = []
    async with streamablehttp_client(mcp_url) as streams:
        read, write = streams[0], streams[1]
        async with ClientSession(read, write) as session:
            await session.initialize()
            tools = (await session.list_tools()).tools
            if TOOL_ALLOW:
                tools = [t for t in tools if t.name in TOOL_ALLOW]
            oai_tools = [to_openai_tool(t) for t in tools]
            log(f"tools={len(oai_tools)} model={model} llm={LLM_BASE}")

            client = OpenAI(base_url=LLM_BASE, api_key=os.environ.get("LOCAL_LLM_KEY", "none"), timeout=600)
            messages: list[dict] = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": prompt}]
            turns = 0
            result = ""
            seen: dict[str, int] = {}
            calls_left = MAX_TOOL_CALLS
            for turn in range(MAX_TURNS):
                last = turn == MAX_TURNS - 1 or calls_left <= 0
                if calls_left <= 0 and messages[-1]["role"] != "user":
                    messages.append({"role": "user", "content": "ツール呼び出しの上限に達しました。ここまでに得た事実だけで、"
                                    "指示された見出し構成(症状 / 仮説と検証 / 結論 / 次の一手)の報告を書いてください。"})
                resp = client.chat.completions.create(
                    model=model, messages=strip_private(messages),
                    tools=oai_tools, tool_choice="none" if last else "auto",
                    max_tokens=int(os.environ.get("LOCAL_MAX_TOKENS", "4000")),
                    # Qwen3 系の推奨値。温度を下げすぎると同じ文を繰り返し始める
                    temperature=float(os.environ.get("LOCAL_TEMPERATURE", "0.6")),
                    top_p=0.95,
                    presence_penalty=float(os.environ.get("LOCAL_PRESENCE_PENALTY", "1.0")),
                )
                turns += 1
                if resp.usage:
                    usage["input_tokens"] += resp.usage.prompt_tokens or 0
                    usage["output_tokens"] += resp.usage.completion_tokens or 0
                    log(f"turn {turns}: prompt_tokens={resp.usage.prompt_tokens} completion={resp.usage.completion_tokens}")
                    if (resp.usage.prompt_tokens or 0) > COMPACT_AT:
                        log(f"compacted {compact(messages)} tool results")
                msg = resp.choices[0].message
                assistant: dict = {"role": "assistant", "content": msg.content or ""}
                reasoning = getattr(msg, "reasoning_content", None)
                if reasoning:
                    assistant["reasoning_content"] = reasoning
                if msg.tool_calls:
                    assistant["tool_calls"] = [{
                        "id": tc.id, "type": "function",
                        "function": {"name": tc.function.name, "arguments": tc.function.arguments or "{}"},
                    } for tc in msg.tool_calls]
                messages.append(assistant)
                if not msg.tool_calls:
                    result = msg.content or ""
                    break
                for tc in msg.tool_calls:
                    name = tc.function.name
                    try:
                        args = json.loads(tc.function.arguments or "{}")
                    except json.JSONDecodeError:
                        args = {}
                    key = name + json.dumps(args, sort_keys=True, ensure_ascii=False)
                    tool_log.append(name)
                    if seen.get(key, 0) >= 1:
                        # 同じ呼び出しの繰り返し。結果を返さず、手元の情報で書くよう促す
                        seen[key] += 1
                        log(f"  {name} repeated x{seen[key]} -> skipped")
                        messages.append({"role": "tool", "tool_call_id": tc.id,
                                         "content": "この呼び出しは既に同じ引数で実行済みです。前の結果を使い、"
                                                    "新しい事実が要らなければ報告を書いてください。"})
                        continue
                    seen[key] = 1
                    try:
                        r = await session.call_tool(name, args)
                        text = "\n".join(getattr(c, "text", "") for c in r.content) or "(結果なし)"
                        if getattr(r, "is_error", None) or getattr(r, "isError", None):
                            text = "error: " + text
                        else:
                            text = shape_result(name, text)
                    except Exception as e:  # noqa: BLE001
                        text = f"error: {e}"
                    if len(text) > MAX_TOOL_CHARS:
                        text = text[:MAX_TOOL_CHARS] + f"…(全 {len(text)} 文字のうち先頭のみ)"
                    calls_left -= 1
                    text += f"\n(残りのツール呼び出し: {max(calls_left, 0)} 回)"
                    log(f"  {name}({json.dumps(args, ensure_ascii=False)[:120]}) -> {len(text)} chars")
                    messages.append({"role": "tool", "tool_call_id": tc.id, "content": text})
            else:
                result = messages[-1].get("content") or "(上限ターン数に達したので中断)"
    if "</think>" in result:
        # llama.cpp が思考部分を分離し損ねたとき、本文だけ残す
        result = result.split("</think>", 1)[1].lstrip()
    result = dedupe_paragraphs(result)
    return {
        "type": "result", "subtype": "success", "is_error": False,
        "duration_ms": int((time.monotonic() - t0) * 1000),
        "num_turns": turns, "result": result, "usage": usage,
        "tool_calls": tool_log, "model": model,
    }


def main() -> int:
    if hasattr(sys.stdout, "reconfigure"):
        sys.stdout.reconfigure(encoding="utf-8")
        sys.stdin.reconfigure(encoding="utf-8")
    parser = argparse.ArgumentParser()
    parser.add_argument("--model", default=os.environ.get("CLAUDE_MODEL", "qwen3.6-35b-a3b"))
    parser.add_argument("--mcp-config", default="mcp.json")
    args, _unknown = parser.parse_known_args()   # claude -p 互換の他の引数は無視する
    with open(args.mcp_config, encoding="utf-8") as fh:
        servers = json.load(fh)["mcpServers"]
    mcp_url = next(iter(servers.values()))["url"]
    prompt = sys.stdin.read()
    out = asyncio.run(run(args.model, mcp_url, prompt))
    print(json.dumps(out, ensure_ascii=False))
    return 0


if __name__ == "__main__":
    sys.exit(main())
負荷と故障注入
loadgen.py 平常時のジョブ投入(5 rps)
"""平常時の負荷。一定のレートで計算ジョブを投入し続ける(標準ライブラリのみ)。

使い方: python loadgen.py [--rps 5] [--seconds 0(無期限)] [--url http://localhost:8100/jobs]

応答を待たずに次を送る(open loop)ので、サーバが遅くなっても送信レートは落ちない。
同時実行が --max-inflight を超えた分は送らずに数える。
"""

from __future__ import annotations

import argparse
import json
import random
import threading
import time
import urllib.error
import urllib.request

USERS = ["sato", "suzuki", "takahashi", "tanaka"]
JOB_TYPES = ["mip", "lp", "simulation", "ml"]


def run(url: str, rps: float, seconds: float, max_inflight: int = 500, timeout: float = 10.0,
        label: str = "loadgen") -> dict:
    stats = {"sent": 0, "ok": 0, "failed": 0, "error": 0, "skipped": 0, "latency": []}
    inflight = threading.Semaphore(max_inflight)
    lock = threading.Lock()

    def one() -> None:
        body = json.dumps({
            "user": random.choice(USERS), "job": random.choice(JOB_TYPES), "size": random.randint(1, 3),
        }).encode("utf-8")
        req = urllib.request.Request(url, data=body, headers={"Content-Type": "application/json"})
        t0 = time.perf_counter()
        try:
            with urllib.request.urlopen(req, timeout=timeout) as resp:
                resp.read()
                key = "ok" if resp.status == 200 else "failed"
        except urllib.error.HTTPError:
            key = "failed"
        except (urllib.error.URLError, TimeoutError, OSError):
            key = "error"
        finally:
            inflight.release()
        with lock:
            stats[key] += 1
            stats["latency"].append(time.perf_counter() - t0)

    deadline = time.time() + seconds if seconds > 0 else float("inf")
    interval = 1.0 / rps
    next_at = time.perf_counter()
    last_report = time.time()
    try:
        while time.time() < deadline:
            now = time.perf_counter()
            if now < next_at:
                time.sleep(next_at - now)
            next_at += interval
            if inflight.acquire(blocking=False):
                stats["sent"] += 1
                threading.Thread(target=one, daemon=True).start()
            else:
                stats["skipped"] += 1
            if time.time() - last_report >= 10:
                last_report = time.time()
                with lock:
                    lat = sorted(stats["latency"][-200:]) or [0.0]
                    p95 = lat[int(len(lat) * 0.95) - 1] if len(lat) > 1 else lat[0]
                    print(f"[{label}] sent={stats['sent']} ok={stats['ok']} failed={stats['failed']} "
                          f"error={stats['error']} skipped={stats['skipped']} p95={p95:.3f}s", flush=True)
    except KeyboardInterrupt:
        pass
    time.sleep(min(timeout, 2.0))
    return stats


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--url", default="http://localhost:8100/jobs")
    parser.add_argument("--rps", type=float, default=5)
    parser.add_argument("--seconds", type=float, default=0, help="0 で無期限(Ctrl+C で止める)")
    parser.add_argument("--max-inflight", type=int, default=500)
    args = parser.parse_args()
    s = run(args.url, args.rps, args.seconds, args.max_inflight)
    print(f"done sent={s['sent']} ok={s['ok']} failed={s['failed']} error={s['error']} skipped={s['skipped']}")
faults/load_spike.py 実験 1: 投入の急増
"""実験 1(レベル 1): リクエストの急増。平常の 5 rps に加えて高レートでジョブを投入する。

使い方: python faults/load_spike.py [--rps 80 --seconds 180 --max-inflight 60]
slot-manager の DB プール(4 本 × 約 80 ms/ジョブ = 50 rps)を超えるので待ちが伸び、
JobApiLatencyHigh(p95 > 0.5 秒が 1 分)が発火する。原因はメトリクス(リクエスト率)だけで分かる。
同時実行を --max-inflight で頭打ちにして、待ち行列が無限に伸びてタイムアウト(failed)に化けるのを防ぐ
(頭打ちなしで 80 rps を送ると job-api の httpx 接続プールが枯渇して 502 が混じり、失敗率のアラートも鳴る)。
"""

from __future__ import annotations

import argparse
import sys
from pathlib import Path

sys.path.insert(0, str(Path(__file__).resolve().parent.parent))
from loadgen import run  # noqa: E402

parser = argparse.ArgumentParser()
parser.add_argument("--url", default="http://localhost:8100/jobs")
parser.add_argument("--rps", type=float, default=80)
parser.add_argument("--seconds", type=float, default=180)
parser.add_argument("--max-inflight", type=int, default=60)
args = parser.parse_args()

s = run(args.url, args.rps, args.seconds, max_inflight=args.max_inflight, label="spike")
print(f"done sent={s['sent']} ok={s['ok']} failed={s['failed']} error={s['error']} skipped={s['skipped']}")
faults/slot_out.py 実験 2: 特定種別の枠切れ(2b は --slots 45)
"""実験 2(レベル 2): 計算枠の枯渇。1 つのジョブ種別の枠を 0 にして、その種別の投入だけを失敗させる。

使い方: python faults/slot_out.py [--job mip --seconds 180]
失敗率が 25% 前後になり JobErrorRateHigh(失敗率 > 20% が 1 分)が発火する。
どの種別かはメトリクスに出ず、slot-manager のログ「failed to reserve: no free slot: mip」にしか無い。

--slots 45 のように少量を残すと、先に「slots running low」の警告ログが出て
Loki ruler の SlotsRunningLow(実験 2b)が鳴る。
"""

from __future__ import annotations

import argparse
import json
import time
import urllib.request

parser = argparse.ArgumentParser()
parser.add_argument("--url", default="http://localhost:8101/admin/fault")
parser.add_argument("--job", default="mip")
parser.add_argument("--slots", type=int, default=0)
parser.add_argument("--seconds", type=float, default=180)
args = parser.parse_args()


def post(body: dict) -> dict:
    req = urllib.request.Request(args.url, data=json.dumps(body).encode("utf-8"),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=10) as resp:
        return json.loads(resp.read())


print(f"slots[{args.job}] = {args.slots} for {args.seconds:.0f}s", flush=True)
post({"slots": {args.job: args.slots}})
try:
    time.sleep(args.seconds)
finally:
    r = post({"slots": {args.job: 10**9}})
    print(f"restored: slots[{args.job}] = {r['slots'][args.job]}")
faults/slow_db.py 実験 3: DB の遅延
"""実験 3(レベル 3): 下流の DB の遅延。slot-manager の DB 問い合わせに待ち時間を足す。

使い方: python faults/slow_db.py [--latency-ms 300 --seconds 180]
投入レートは変えないのに job-api の p95 が伸び、実験 1 と同じ JobApiLatencyHigh が発火する。
トレースを見ると slot-manager の db.query スパンが時間を占めている。
"""

from __future__ import annotations

import argparse
import json
import time
import urllib.request

parser = argparse.ArgumentParser()
parser.add_argument("--url", default="http://localhost:8101/admin/fault")
parser.add_argument("--latency-ms", type=float, default=300)
parser.add_argument("--seconds", type=float, default=180)
args = parser.parse_args()


def post(body: dict) -> dict:
    req = urllib.request.Request(args.url, data=json.dumps(body).encode("utf-8"),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=10) as resp:
        return json.loads(resp.read())


print(f"latency_ms = {args.latency_ms:.0f} for {args.seconds:.0f}s", flush=True)
post({"latency_ms": args.latency_ms})
try:
    time.sleep(args.seconds)
finally:
    r = post({"latency_ms": 0})
    print(f"restored: latency_ms = {r['fault']['latency_ms']}")
faults/retry_storm.py 実験 3b: 二重投入のバグ
"""実験 3b(任意): 二重投入のバグ。job-api が 1 ジョブあたり slot-manager を N 回呼ぶ。

使い方: python faults/retry_storm.py [--calls 8 --seconds 180]
5 回だと 1 ジョブ 0.43 秒で p95 がしきい値 0.5 秒に届かないことがある。8 回で約 0.7 秒。
投入レートも DB も変わらないのに p95 が伸びる。原因はトレースの構造(子スパンが N 本)にしか現れない。
"""

from __future__ import annotations

import argparse
import json
import time
import urllib.request

parser = argparse.ArgumentParser()
parser.add_argument("--url", default="http://localhost:8100/admin/fault")
parser.add_argument("--calls", type=int, default=8)
parser.add_argument("--seconds", type=float, default=180)
args = parser.parse_args()


def post(body: dict) -> dict:
    req = urllib.request.Request(args.url, data=json.dumps(body).encode("utf-8"),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=10) as resp:
        return json.loads(resp.read())


print(f"duplicate_calls = {args.calls} for {args.seconds:.0f}s", flush=True)
post({"duplicate_calls": args.calls})
try:
    time.sleep(args.seconds)
finally:
    r = post({"duplicate_calls": 1})
    print(f"restored: duplicate_calls = {r['fault']['duplicate_calls']}")
テスト
tests/test_investigate.py claude をモックにして受け口を通す
"""受け口の起動テスト。claude をモックし、偽の Grafana に annotation が届くことを確認する。

実行: uv run --no-project python tests/test_investigate.py
"""

import json
import os
import subprocess
import sys
import tempfile
import time
import urllib.request
from http.server import BaseHTTPRequestHandler, HTTPServer
from pathlib import Path
from threading import Thread

HERE = Path(__file__).resolve().parent
ROOT = HERE.parent
received: list[dict] = []


class FakeGrafana(BaseHTTPRequestHandler):
    def do_POST(self):  # noqa: N802
        n = int(self.headers.get("Content-Length", "0"))
        received.append({
            "path": self.path,
            "auth": self.headers.get("Authorization"),
            "body": json.loads(self.rfile.read(n)),
        })
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.end_headers()
        self.wfile.write(b'{"id":1,"message":"Annotation added"}')

    def log_message(self, *a):  # noqa: D102
        return


def main() -> int:
    grafana = HTTPServer(("127.0.0.1", 0), FakeGrafana)
    Thread(target=grafana.serve_forever, daemon=True).start()
    gport = grafana.server_address[1]

    with tempfile.TemporaryDirectory() as tmp:
        # claude の代わりにモックを起動させる(CLAUDE_BIN は空白区切りのコマンドでもよい)
        env = {
            **os.environ,
            "PORT": "9195",
            "CLAUDE_BIN": f"{sys.executable} {HERE / 'mock_claude.py'}",
            "REPORT_DIR": tmp,
            "GRAFANA_URL": f"http://127.0.0.1:{gport}",
            "GRAFANA_SA_TOKEN": "",
            "GRAFANA_BASIC_AUTH": "admin:admin",
        }
        proc = subprocess.Popen([sys.executable, str(ROOT / "investigate.py")], env=env)
        try:
            time.sleep(1.0)
            payload = (HERE / "sample_alert.json").read_bytes()
            req = urllib.request.Request(
                "http://127.0.0.1:9195/alert", data=payload,
                headers={"Content-Type": "application/json"}, method="POST",
            )
            with urllib.request.urlopen(req, timeout=5) as resp:
                assert resp.status == 200, resp.status
            # 同じ fingerprint を再送しても 2 回目は調査しない
            with urllib.request.urlopen(req, timeout=5):
                pass
            for _ in range(50):
                if received:
                    break
                time.sleep(0.1)
        finally:
            proc.terminate()
            proc.wait(timeout=5)

        reports = sorted(Path(tmp).glob("*_JobApiLatencyHigh.md"))
        assert len(reports) == 1, reports
        text = reports[0].read_text(encoding="utf-8")
        assert "## 結論" in text and "モックの結論" in text, text
        assert (Path(tmp) / "results.jsonl").exists()
        assert len(received) == 1, received
        assert received[0]["path"] == "/api/annotations"
        assert received[0]["auth"].startswith("Basic "), received[0]["auth"]
        assert "JobApiLatencyHigh" in received[0]["body"]["tags"]
        # プロンプトに Loki / Tempo の手順が入っていること
        prompt = (ROOT / "PROMPT.md").read_text(encoding="utf-8")
        assert "query_loki_logs" in prompt and "tempo_traceql-search" in prompt
    print("ok")
    return 0


if __name__ == "__main__":
    sys.exit(main())
tests/mock_claude.py
"""claude CLI のモック。stdin のプロンプトを受け取り、--output-format json と同じ形の結果を返す。"""

import json
import sys

sys.stdin.reconfigure(encoding="utf-8")
sys.stdout.reconfigure(encoding="utf-8")  # 本物の claude と同じく UTF-8 で返す
prompt = sys.stdin.read()
print(json.dumps({
    "type": "result",
    "subtype": "success",
    "is_error": False,
    "duration_ms": 1234,
    "num_turns": 5,
    "result": "## 症状\n\n(モック)プロンプト長 " + str(len(prompt)) + " 文字\n\n## 結論\n\nモックの結論\n",
    "total_cost_usd": 0.01,
    "usage": {"input_tokens": 100, "output_tokens": 50},
}, ensure_ascii=False))
tests/sample_alert.json
{
  "version": "4",
  "groupKey": "{}:{alertname=\"JobApiLatencyHigh\"}",
  "status": "firing",
  "receiver": "ai-investigator",
  "groupLabels": { "alertname": "JobApiLatencyHigh" },
  "commonLabels": { "alertname": "JobApiLatencyHigh", "severity": "warning" },
  "externalURL": "http://alertmanager:9093",
  "alerts": [
    {
      "status": "firing",
      "labels": {
        "alertname": "JobApiLatencyHigh",
        "severity": "warning"
      },
      "annotations": {
        "summary": "ジョブ投入 API の p95 レイテンシが 1 分以上 0.5 秒を超えている",
        "description": "直近 2 分の p95 = 1.2s"
      },
      "startsAt": "2026-09-12T05:23:45.000Z",
      "endsAt": "0001-01-01T00:00:00Z",
      "generatorURL": "http://prometheus:9090/graph?g0.expr=...",
      "fingerprint": "a1b2c3d4e5f60718"
    }
  ]
}